Setting training, Temporary Chat, Memory, dan apa yang dilihat admin — dengan gambar asli
Total inti (00–06): 90 menit.
Dua Framework di Materi Ini
SIAP (Situasi, Instruksi, Acuan, Pola Output) — untuk prompting umum, diajarkan di bagian 03.
DATA (Data dulu, Aturan larangan mengarang, Tanya balik, Audit sumber) — untuk kerja analisis data/laporan, modul lanjutan di bagian 07.
Prinsip lintas-sesi: AI membantu, manusia memutuskan. Diperkenalkan di bagian 04 (tiga zona data) dan 06, lalu dikembangkan jadi prinsip OWN di Leading Self 2A. *
Kebutuhan Teknis Fasilitator
Laptop/ponsel dengan akun ChatGPT (versi gratis cukup untuk demo).
Koneksi internet stabil.
Contoh data kecil (untuk modul 07) dan satu file PDF pendek (untuk demo upload di bagian 05).
3
Target
Apa yang harus dicapai & cara mengukurnya
Output Pembelajaran
Peserta memahami dasar AI, mampu membuat prompt (framework SIAP), memahami keamanan data, dan mampu menggunakan AI secara tepat dengan tetap melakukan validasi.
Materi 1 · Leading Self 1 — Materi Dasar AI
00Pembukaan
Durasi5 menit
Slide terkait
Alur Materi 1
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan
Sesi ini bukan kelas teori AI. Fokusnya tiga hal: paham cara kerja AI secukupnya untuk percaya diri memakainya, bisa menyusun instruksi (prompt) yang menghasilkan output yang dipakai, dan tahu batas aman soal data sebelum mengetik apa pun ke AI eksternal.
Sampaikan kontrak sesi secara langsung:
90 menit, 6 bagian inti + 1 modul lanjutan opsional.
Setiap bagian ditutup dengan satu kalimat kunci sebelum lanjut — supaya tidak kehilangan alur.
Bawa laptop atau ponsel dengan koneksi internet. Praktik dilakukan langsung, bukan dibayangkan.
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Tahapan Pelaksanaan
Perkenalan singkat fasilitator (1').
Tanya cepat: "Siapa yang sudah pernah pakai ChatGPT/AI apa pun sebelumnya?" — untuk kalibrasi kecepatan penyampaian (2').
Sampaikan kontrak sesi di atas (1').
Sampaikan output akhir sesi: peserta paham dasar AI, mampu membuat prompt, memahami keamanan data, dan mampu memakai AI dengan tetap melakukan validasi (1').
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta:
Paham bahwa sesi ini berorientasi paham + praktik, bukan teori panjang.
Tahu persis apa yang akan mereka bawa pulang di akhir sesi.
Capaian Bagian Ini
Peserta memahami relevansi sesi terhadap pekerjaannya dan tahu jelas apa yang akan mereka peroleh di akhir 90 menit.
Indikator Keberhasilan
Minimal 70% peserta merespons aktif pada tanya cepat pembuka.
Jangkar penutup90 menit ini kita jalan cepat — paham dulu, langsung coba, baru lanjut. Siap?
Materi 1 · Leading Self 1 — Materi Dasar AI
01Pemahaman Data dan Cara Kerja AI
Durasi10 menit
Slide terkait
Alur Materi 1
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan
Sebelum masuk ke istilah AI/LLM, peserta perlu paham satu hal dasar: AI tidak "tahu" apa-apa dari lahir — semua kemampuannya berasal dari data yang dipelajari selama proses pelatihan (training). Semakin besar dan beragam data yang dipelajari, semakin luas pola yang dikenali AI. Sebaliknya, AI tidak bisa menjawab akurat soal sesuatu yang tidak ada polanya di data pelatihan, atau yang terjadi setelah data itu dikumpulkan.
Cara kerjanya: AI membaca instruksi kita, lalu memprediksi kata demi kata yang paling mungkin muncul selanjutnya, berdasarkan pola dari miliaran contoh teks yang pernah dipelajari. Ini bukan mengambil jawaban jadi dari database seperti mesin pencari — AI menyusun jawaban baru setiap kali, kata demi kata, secara real-time.
Poin Penting yang Ditekankan
AI bukan mesin pencari. Ia menyusun jawaban baru, tidak mengambil dari basis data yang sudah pasti benar.
Karena berbasis prediksi pola, AI bisa salah dengan nada percaya diri (dibahas lebih dalam di bagian 04).
Kualitas dan kelengkapan data pelatihan menentukan seberapa baik AI menjawab — ini kenapa setiap platform AI punya karakter berbeda (dibahas di bagian 02).
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Tahapan Pelaksanaan
Aktivitas Tebak Kata (3'). Ajak peserta melengkapi kalimat serentak secara lisan:
"Selamat pagi, apa ___?" → hampir semua jawab "kabar"
"Terima kasih banyak atas ___" → "bantuannya" / "waktunya"
Tunjukkan: jawaban kompak karena otak menebak pola dari kalimat yang sering didengar — bukan kebetulan.
Jembatani ke AI (3'). Sampaikan: AI melakukan hal serupa, tapi belajar pola dari membaca miliaran contoh teks (buku, artikel, percakapan) saat dilatih — bukan dari pengalaman hidup. Karena skalanya sangat besar, AI jadi sangat jago menebak kelanjutan kalimat atau jawaban yang paling masuk akal.
Definisi Formal (2').AI (generatif) = program yang dilatih dari data dalam jumlah sangat besar, sehingga bisa memprediksi dan menyusun jawaban yang paling masuk akal terhadap instruksi kita.
Demo Live (2'). Ketik satu pertanyaan sederhana di ChatGPT di depan peserta. Minta peserta perhatikan: jawaban muncul kata demi kata, bukan langsung utuh — bukti visual dari proses menebak berulang.
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta mampu:
Menjelaskan dengan bahasa sendiri kenapa data adalah bahan baku utama AI.
Menjelaskan cara AI menyusun jawaban (menebak pola), tanpa istilah teknis.
Capaian Bagian Ini
Konsep: AI generatif menghasilkan jawaban lewat prediksi, bukan mengambil jawaban siap pakai dari basis data.
Mekanisme: AI menyusun jawaban bertahap dengan menebak kelanjutan paling mungkin, berdasarkan pola dari data skala besar.
Indikator Keberhasilan
Peserta mampu menjelaskan ulang cara kerja AI dengan kata kunci "menebak" atau "memprediksi pola" — bukan sekadar label "program pintar".
Jangkar penutupJadi AI itu menebak pola dari data raksasa. Sekarang kita kenalan sama pemain-pemain besar yang pakai cara kerja ini.
Materi 1 · Leading Self 1 — Materi Dasar AI
02Mengenal AI, LLM, GPT, Gemini, Claude
Durasi15 menit
Slide terkait
Alur Materi 1
1
Penjelasan
Konsep & alasan di balik bagian ini
Catatan waktu: Bagian "Apa Itu Model" sampai "Praktik: Tes 3 Menit" adalah bacaan lanjutan; di sesi 15 menit cukup sebut tiga nama (Luna, Sol, Astra) dan pesan "pilih model yang cukup, bukan yang terbesar".
Penjelasan
LLM (Large Language Model) adalah jenis model AI yang dilatih khusus untuk memahami dan menghasilkan bahasa manusia — inilah "mesin" di balik ChatGPT, Claude, dan Gemini. Ketiganya menggunakan prinsip dasar yang sama (dibahas di bagian 01): menebak pola dari data besar. Perbedaan di antara mereka bukan pada konsep dasarnya, tapi pada data pelatihan, cara "diasah" setelah pelatihan, dan ekosistem produk di sekitarnya.
Tiga pemain utama:
ChatGPT — dibuat OpenAI.
Claude — dibuat Anthropic.
Gemini — dibuat Google.
Disebut sekilas saja (tanpa perlu dibahas dalam, cukup 1 kalimat): Microsoft Copilot (mirip ChatGPT, terintegrasi Office/Windows), Perplexity (fokus pencarian dengan sitasi), Meta AI (bawaan WhatsApp/Instagram), Grok (terintegrasi X), DeepSeek (open-source, murah).
Apa Itu "Model"?
Model adalah "otak" yang sudah selesai dilatih: file besar berisi pola bahasa hasil belajar dari data (lihat bagian 01). ChatGPT, Claude, dan Gemini adalah aplikasinya, sedangkan model adalah mesin di dalamnya. Analogi: aplikasi itu mobil, model itu mesin. Pabrik bisa ganti mesin tanpa mengganti mobil, jadi nama aplikasinya sama tetapi kemampuannya bisa berubah.
Satu perusahaan biasanya membuat satu keluarga model dengan ukuran berbeda. Makin besar dan "berpikir" makin lama, umumnya makin teliti, tetapi makin lambat, makin mahal, dan jatahnya makin terbatas. Karena itu pertanyaan yang tepat bukan "model mana yang terbaik?", tetapi "model mana yang cukup untuk tugas ini?"
Model GPT Saat Ini: Apa Bedanya?
Per 15 Oktober 2026, OpenAI memakai nama keluarga Luna (kecil, cepat, murah), Sol (menengah, model harian berbayar), dan Astra (terbesar, paling pintar). Model baru ditambahkan tiap beberapa minggu, jadi anggap daftar ini foto sesaat.
Model
Posisinya
Di ChatGPT
Harga API per 1 juta token (masuk / keluar)
GPT-6 Luna
Tercepat dan termurah
Model bawaan paket Free dan Go
US$0,10 / US$0,50
GPT-6 Sol
Model harian untuk pekerjaan kompleks
Di balik pilihan Instant, Medium, High, Extra High untuk Plus, Pro, Business, Enterprise
US$2 / US$10
GPT-6 Astra
Terpintar, untuk tugas paling berat dan panjang
Di balik pilihan Pro (paket Pro dan Business/Enterprise); Plus hanya di ChatGPT Work dan Codex
US$10 / US$50
GPT-6.1 Sol
Versi Sol terbaru
Hanya di ChatGPT Work dan Codex
US$2 / US$10
GPT-5.6 Sol / Sol Pro
Generasi sebelumnya, masih bisa dipilih manual
Pilih "GPT-5.6 Sol" di menu model
Sol: tidak tercantum di halaman harga utama
Catatan: harga API hanya relevan kalau kamu membangun aplikasi atau otomasi sendiri. Pengguna aplikasi ChatGPT membayar langganan, bukan per token.
Pilihan "Thinking" di ChatGPT
Di paket berbayar, kamu memilih seberapa lama model berpikir lewat penggeser:
Instant: jawaban cepat untuk pertanyaan sehari-hari.
Medium: berpikir standar.
High: berpikir lebih panjang untuk masalah berlapis.
Extra High: tingkat tertinggi dari Sol (Plus tidak mendapat ini).
Pro: memakai model Pro (Astra) untuk tugas sulit, dengan batas pemakaian mingguan.
Penting: sejak 14 September 2026, Instant di Plus dan Pro tidak lagi berpindah sendiri ke mode berpikir. Menulis "pikir lebih dalam" di prompt juga tidak mengubahnya. Kamu sendiri yang harus menaikkan tingkatnya. Paket Free dan Go punya tombol Think yang memakai Luna.
Kelebihan dan Kekurangan Tiap Model GPT
Ringkasan di bawah disusun dari deskripsi resmi OpenAI dan halaman harganya. Klaim benchmark OpenAI sendiri belum diuji pihak independen, jadi anggap sebagai petunjuk, bukan bukti.
Model
Kelebihan
Kekurangan
Luna
Cepat, termurah, gratis di aplikasi; cukup untuk ringkasan, draf, perapian teks, tanya-jawab harian. OpenAI menyebut Luna (usaha tinggi) menyamai GPT-5.6 Sol pada uji faktualitas internal dengan biaya jauh lebih kecil
Model terkecil di keluarganya, jadi untuk analisis berlapis atau tugas panjang yang butuh ketelitian tinggi sebaiknya diuji dulu atau naik ke Sol; fitur seperti upload, gambar, dan riset mendalam dibatasi
Sol
Keseimbangan kemampuan dan biaya; kamu bisa mengatur kedalaman berpikir (Medium sampai Extra High); fitur Intelligent UI (jawaban berupa grafik/elemen interaktif)
Butuh langganan berbayar; makin tinggi tingkat berpikir, makin lama dan makin cepat menghabiskan jatah
Astra / Pro
Paling pintar untuk tugas sulit dan panjang
Paling mahal, ada batas pemakaian mingguan walau sudah berlangganan Pro, lebih lambat; tidak mendukung Intelligent UI
GPT-5.6 Sol
Masih tersedia bila kamu lebih suka perilaku versi sebelumnya
Generasi lama; tidak ada alasan memilihnya untuk pemula selain kebiasaan
Cara Tahu Bedanya
Lihat label di pemilih model (menu di kotak pesan pada versi web, atau di bagian atas percakapan di HP). Paket Free tidak punya pilihan: modelnya Luna.
Jangan menilai dari satu jawaban. Jawaban bagus belum tentu karena modelnya, bisa karena prompt-nya.
Uji dengan tugas kerjamu sendiri, bukan soal contoh. Pakai praktik di bawah.
Yang Paling Murah, dan Apakah Perlu?
Yang paling murah:
Aplikasi ChatGPT: Free (US$0, chat teks tanpa batas dengan GPT-6 Luna, fitur lain terbatas), lalu Go (US$8 per bulan, bisa memuat iklan), Plus (US$20), dan Pro (mulai US$100).
API: GPT-6 Luna, US$0,10 input / US$0,50 output per 1 juta token. Lewat Batch atau Flex setengahnya.
Apakah perlu mengejar yang termurah? Untuk pemula: tidak sebagai tujuan, tetapi sebagai titik mulai.
Mulai dari Free. Kalau Luna cukup untuk tugasmu, tidak ada alasan membayar.
Naik ke Plus kalau kamu sering memotong pekerjaan karena jawaban dangkal, butuh file panjang, atau butuh tingkat berpikir Medium/High.
Pro atau Astra hampir tidak diperlukan pemula: mahal, jatahnya terbatas, dan tugas sulit biasanya bisa dipecah jadi langkah kecil dengan model yang lebih ringan.
Hitung biaya salah, bukan hanya harga langganan. Draf email yang keliru murah diperbaiki. Angka laporan klien yang keliru tidak. Untuk yang kedua, model lebih kuat ditambah verifikasi manual (lihat framework DATA di bagian 07) lebih penting daripada hemat beberapa dolar.
Harga di atas dalam dolar AS dan bisa berbeda per wilayah. Cek halaman harga resmi sebelum berlangganan.
Tabel Komparasi ChatGPT vs Claude vs Gemini
Aspek
ChatGPT (OpenAI)
Claude (Anthropic)
Gemini (Google)
Paket Gratis
GPT-6 Luna: chat teks tanpa batas, fitur lain (upload, gambar, riset) terbatas
Konteks besar (200K token), limit heavy-use cepat tercapai
Model Flash saja, konteks ~32K token
Paket Berbayar
Go US$8/bln, Plus US$20/bln, Pro mulai US$100/bln
Pro ±US$17–20/bln, Max US$100–200/bln
Google AI Pro/Advanced ±US$20/bln
Keunggulan Utama
Ekosistem terluas, integrasi pihak ketiga terbanyak, unggul gambar/video
Kualitas penalaran & tulisan rapi, unggul coding & dokumen panjang, memori kuat
Terintegrasi penuh Google Workspace, konteks sangat besar di paket Advanced
Keterbatasan Utama
Limit gratis cepat habis, harga paket tertinggi
Ekosistem integrasi belum seluas ChatGPT
Kualitas kreatif relatif kurang natural
Paling Cocok Untuk
Kebutuhan umum harian & kreatif
Dokumen formal, analisis mendalam, coding
Pengguna berat Google Workspace & riset
Catatan fasilitator: harga dan fitur berubah cepat. Sampaikan ke peserta bahwa tabel ini adalah gambaran per periode pelatihan — cek ulang harga resmi sebelum berlangganan.
Kelebihan dan Kekurangan — Lebih Detail
Tabel ringkas di atas cukup untuk sesi 15 menit. Untuk peserta yang bertanya lebih dalam, ini rinciannya:
ChatGPT (OpenAI)
Kelebihan: ekosistem plugin/integrasi pihak ketiga paling luas; paling banyak tutorial dan komunitas; kuat untuk pembuatan gambar (DALL·E) dan video (Sora); paling mudah dipelajari pemula karena alurnya sederhana (upload, tanya, dapat jawaban).
Kekurangan: limit paket gratis cepat habis untuk pemakaian intensif; harga paket tertinggi (Pro) di antara ketiganya; tidak punya akses langsung ke database/warehouse — semua kerja file berjalan di sandbox terisolasi.
Claude (Anthropic)
Kelebihan: kualitas penalaran dan tulisan paling rapi untuk dokumen formal & coding; context window besar (hingga 1 juta token pada tingkat tertentu) untuk sesi eksplorasi panjang; cenderung lebih berhati-hati mengakui ketidakpastian daripada mengarang jawaban — tingkat halusinasi paling rendah di antara ketiganya menurut pembanding independen.
Kekurangan: ekosistem integrasi pihak ketiga belum seluas ChatGPT; tidak punya notebook/BI product khusus untuk data science berat.
Gemini (Google)
Kelebihan: terintegrasi penuh dengan Google Workspace (Docs, Sheets, Gmail); context window terbesar (hingga 2 juta token pada tingkat tertentu); satu-satunya yang native terhubung ke BigQuery untuk data skala gudang data (data warehouse).
Kekurangan: kualitas jawaban kreatif relatif kurang natural dibanding dua lainnya; fitur data paling kuatnya (BigQuery, Data Science Agent di Colab) butuh setup teknis — kurang ramah untuk pengguna non-teknis yang cuma mau analisis cepat.
Tujuan Terbaik — Kapan Pakai yang Mana
Pakai ChatGPT kalau: kerja harian umum, butuh brainstorming cepat, bikin konten kreatif (teks/gambar/video), atau baru belajar dan mau alur paling sederhana.
Pakai Claude kalau: menulis dokumen formal/laporan panjang, coding, atau kerja apa pun yang akurasinya kritis dan tidak boleh "dihaluskan" dengan asumsi.
Pakai Gemini kalau: kerja sudah menyatu dengan Google Workspace (Sheets/Docs/Gmail), atau perlu mengolah data dalam volume sangat besar yang sudah tersimpan di BigQuery.
Perbandingan Khusus: Pengolahan Data
Karena ini pertanyaan yang sering muncul, berikut perbandingan ketiganya spesifik untuk kerja data (upload CSV/Excel, analisis, bikin laporan):
Aspek
ChatGPT
Claude
Gemini
Upload CSV/Excel
Bisa langsung upload, diproses lewat Python di sandbox — paling mudah untuk pemula
Terintegrasi ke Excel (Claude for Excel): edit formula & sitasi per-sel langsung di file
Lewat Google Sheets/Colab; kekuatan penuhnya butuh BigQuery — kurang praktis untuk file lepas
Eksekusi kode
Python berjalan langsung (pandas, NumPy, Matplotlib), kode ditampilkan agar bisa dicek
Punya tool analisis sendiri, hasil cenderung disertai penjelasan yang bisa ditelusuri
Data Science Agent di Colab bisa bikin notebook otomatis, kuat untuk data skala besar
Bikin grafik
Cepat, bisa revisi langsung, kode di balik grafik terlihat
Bisa, biasanya lewat integrasi Excel
Bisa, muncul di dalam notebook Colab
Kapasitas data besar
Cukup untuk file yang wajar diupload manual
Context window besar — cocok untuk eksplorasi data panjang dalam satu sesi
Terkuat untuk data betul-betul besar via BigQuery
Risiko mengarang angka
Ada, seperti semua LLM — perlu verifikasi
Relatif paling rendah — lebih sering mengakui "tidak tahu" daripada menebak
Ada, terutama di luar konteks yang didukung data warehouse
Paling cocok untuk
Pemula yang mau upload file dan langsung tanya
Kerja yang hasilnya harus akurat & bisa dipertanggungjawabkan (laporan klien)
Tim yang datanya sudah di ekosistem Google/BigQuery
Rekomendasi praktis: untuk peserta pemula yang baru mulai olah data, mulai dari ChatGPT karena alurnya paling sederhana. Begitu kerjanya menyangkut laporan yang harus akurat (angka klien, keuangan), pindah ke Claude atau tetap di ChatGPT/Gemini tapi wajib pakai framework anti-halusinasi — lihat 07 — Framework DATA.
Ambil satu tugas nyata dari pekerjaanmu (bukan data rahasia), jalankan dua kali: sekali di model ringan (Free atau Instant), sekali di model yang lebih kuat (Think, Medium atau High). Salin prompt ini:
Konteks: [tempel 1 paragraf/tabel kecil dari pekerjaanmu, tanpa data sensitif].
Tugas: Ringkas dalam 3 poin, lalu sebutkan 2 hal yang kurang jelas atau mungkin keliru dari teks tadi.
Format: poin singkat, bahasa Indonesia sehari-hari.
Bandingkan dengan tiga pertanyaan:
Tepat? Apakah angka dan fakta cocok dengan teks aslimu?
Dalam? Apakah dua hal yang "kurang jelas" benar-benar relevan atau hanya basa-basi?
Sepadan? Apakah selisih mutunya sepadan dengan selisih waktu dan jatah pakainya?
Kalau hasilnya hampir sama, tetaplah di model yang lebih ringan.
Tahapan Pelaksanaan
Jelaskan definisi LLM dan hubungannya dengan ChatGPT/Claude/Gemini (3').
Sebutkan sekilas platform pelengkap (2').
Paparkan tabel komparasi utama, jelaskan tiap baris (5').
Singgung perbandingan pengolahan data secukupnya — cukup rekomendasi praktisnya, detail tabel jadi bahan bacaan lanjutan (2').
Diskusi reflektif singkat: platform mana yang paling relevan untuk pekerjaan peserta, dan kenapa (3').
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta mampu:
Menjelaskan apa itu LLM dalam satu kalimat sederhana.
Menyebutkan minimal 3 platform AI populer beserta satu ciri pembeda masing-masing.
Memilih platform yang sesuai untuk kebutuhan kerjanya sendiri.
Capaian Bagian Ini
Konsep: Nama, pengembang, dan satu ciri pembeda utama dari masing-masing platform.
Mekanisme pemilihan: Semua platform berjalan dengan prinsip dasar yang sama; perbedaan ada di ekosistem, harga, dan fitur tambahan — bukan konsep intinya.
Indikator Keberhasilan
Peserta mampu menyebutkan minimal satu alasan pemilihan platform tertentu yang relevan dengan kebutuhan kerjanya.
Jangkar penutupPlatform boleh beda, tapi prinsip interaksinya tetap sama. Sekarang kita masuk ke bagian paling penting: cara menyusun instruksi.
Materi 1 · Leading Self 1 — Materi Dasar AI
03Pemahaman Prompt dan Cara Penggunaannya
Durasi20 menit
Slide terkait
Alur Materi 1
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan: Token dan Prompt
Token adalah satuan terkecil pemrosesan teks bagi AI — bisa satu kata utuh, bisa juga sebagian kata. Analoginya: token itu kepingan puzzle kecil; kalimat panjang dipecah jadi kepingan-kepingan ini, lalu disusun ulang jadi jawaban. Ini kenapa ada limit di paket gratis (dihitung dari jumlah token), dan kenapa percakapan yang terlalu panjang bisa membuat AI "lupa" bagian awal.
Prompt adalah instruksi atau pertanyaan yang kita ketik ke AI — satu-satunya cara kita mengarahkan hasilnya. Analoginya: prompt itu seperti brief ke asisten baru. Brief jelas → hasil sesuai ekspektasi. Brief samar → AI menebak-nebak, dan tebakannya sering meleset.
Bagian B — Kenapa Meleset (3')
Jelaskan: AI mengisi kekosongan informasi dengan asumsi ketika instruksi tidak lengkap. Semakin lengkap prompt, semakin kecil ruang bagi AI untuk berasumsi keliru. Tunjukkan contoh nyata dari prompt peserta: bagian mana yang ambigu, apa yang AI terpaksa asumsikan.
Bagian C — Framework SIAP (5')
Perkenalkan framework 4 elemen berikut. Ini yang membuat prompt "asal" jadi terstruktur tanpa perlu dihafal rumit:
Huruf
Elemen
Isi
Contoh
S
Situasi
Peran AI + konteks kerja
"Kamu asisten HR di perusahaan retail"
I
Instruksi
Tugas spesifik, pakai kata kerja jelas
"Buatkan surat peringatan pertama untuk karyawan yang sering terlambat"
A
Acuan
Batasan: panjang, nada, hal wajib/tidak boleh
"Nada tegas tapi tidak menyinggung, maksimal 200 kata"
P
Pola Output
Bentuk hasil akhir
"Format surat resmi"
Prompt lengkap gabungan:"Kamu asisten HR di perusahaan retail. Buatkan surat peringatan pertama untuk karyawan yang sering terlambat. Nada tegas tapi tidak menyinggung, maksimal 200 kata. Format surat resmi."
Cara pakai cepat: sebelum kirim prompt, cek 4 huruf ini satu-satu — kalau salah satu kosong, isi dulu sebelum kirim.
Contoh Tambahan (Bad vs Good)
Prompt Asal
Kenapa Kurang
Prompt Pakai SIAP
"Jelasin marketing"
Terlalu luas, AI menebak level pemahaman & fokus
"Kamu konsultan marketing UMKM (S). Jelasin strategi promosi untuk UMKM kuliner (I). Budget promosi terbatas, dalam 5 poin praktis (A). Format poin bernomor (P)"
"Perbaiki ini"
AI tidak tahu standar perbaikan
"Kamu editor bahasa profesional (S). Perbaiki email ini (I). Supaya lebih sopan dan ringkas, maksimal 100 kata (A). Tampilkan hasil dan versi asli berdampingan (P)"
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Bagian A — Coba Dulu, Tanpa Struktur (5')
Sebelum diajari teori, peserta langsung mencoba. Ini penting: pengalaman "meleset" dulu membuat framework di bawah terasa perlu, bukan sekadar teori tambahan.
Instruksi ke peserta:"Buka ChatGPT/AI apa pun. Ketik satu prompt tentang pekerjaanmu — apa saja, tanpa perlu dipikir panjang. Lihat hasilnya."
Minta 2–3 peserta membacakan prompt dan hasilnya. Biasanya hasilnya generik, terlalu umum, atau meleset dari yang dimaksud. Ini titik masuk pembahasan berikutnya.
Bagian D — Revisi dan Uji Ulang (7')
Peserta mengambil prompt asal mereka dari Bagian A.
Susun ulang memakai SIAP — tulis 4 elemen secara eksplisit dulu, baru gabungkan jadi satu paragraf.
Kirim ke AI, bandingkan hasil sebelum vs sesudah.
Bahas 1–2 contoh di depan kelas.
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta mampu:
Menjelaskan apa itu token dan prompt dengan bahasa sendiri.
Menyusun ulang prompt asal-asalan menjadi prompt terstruktur, secara mandiri.
Menggunakan framework SIAP setiap kali membuat prompt baru.
Mekanisme: AI mengisi kekosongan instruksi dengan asumsi; prompt terstruktur (SIAP) mengecilkan ruang asumsi yang keliru.
Indikator Keberhasilan
Minimal 2 peserta berhasil menyusun ulang prompt mereka memakai SIAP secara mandiri, dan bisa menunjukkan perbedaan hasil sebelum-sesudah.
Jangkar penutupSIAP itu bekal seumur pakai AI — dipakai di ChatGPT, Claude, atau Gemini, sama saja. Sekarang, sebelum lanjut praktik lebih jauh, kita bahas dulu batas amannya.
Materi 1 · Leading Self 1 — Materi Dasar AI
04Keamanan Data dan Risiko Penggunaan AI Eksternal
Durasi15 menit
Slide terkait
Alur Materi 1
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan
Setiap kali kita mengetik sesuatu ke ChatGPT/Claude/Gemini, data itu terkirim ke server perusahaan pembuatnya. Ini bukan soal AI-nya "jahat" — ini konsekuensi teknis biasa dari layanan berbasis cloud. Masalahnya muncul kalau kita mengetik data yang seharusnya tidak keluar dari perusahaan atau dari data klien, tanpa sadar konsekuensinya.
Prinsip dasar: anggap semua yang diketik ke AI eksternal sebagai informasi yang berpotensi tidak sepenuhnya privat, kecuali sudah dipastikan sebaliknya (lewat pengaturan akun atau jenis paket yang dipakai).
Tiga Zona: Boleh, Hati-hati, Dilarang *
Sebelum mengetik, tanyakan: data ini masuk zona mana?
Zona
Jenis data
Aturan
Boleh
Informasi publik & umum: konsep dasar, ide brainstorming, bahan belajar, perbaikan tata bahasa
Aman dipakai di AI eksternal
Hati-hati
Data operasional internal: dokumen perusahaan, data finansial ringan, prosedur kerja
Hanya lewat alat AI resmi yang disetujui IT/kantor, atau samarkan dulu
Dilarang keras
Data rahasia & sensitif: password, kredensial bank, data pribadi karyawan/klien (KTP, gaji), spesifikasi teknis rahasia, kontrak legal
Jangan diketik sama sekali
Aturan emas: ragu? Jangan masukkan ke AI. Tanya tim IT atau HR/kepatuhan di tempat kerja. Dasar pemikirannya: begitu data masuk ke AI eksternal, kamu yang bertanggung jawab atas keputusan itu — ini bagian dari prinsip kepemilikan yang dilanjutkan di Leading Self 2A.
Data yang Perlu Dihindari Masuk ke Prompt
Daftar ini disusun untuk peserta umum (bukan cuma developer) — jadi fokusnya data yang bisa dijumpai siapa saja di pekerjaan kantor sehari-hari:
Kredensial pribadi: password, PIN, kode OTP/verifikasi.
Identitas perusahaan/klien: nama perusahaan asli, nama klien, nama proyek — kalau isi percakapan menyangkut pekerjaan untuk pihak lain, ini yang paling sering bocor tanpa sadar karena terasa "biasa saja" untuk diketik.
Data pribadi pihak ketiga: NIK, nomor rekening, alamat rumah karyawan/klien.
Data kesehatan: riwayat penyakit, hasil medical check-up, kondisi kesehatan karyawan/klien — ini kategori paling sensitif, jangan dimasukkan ke prompt sama sekali walau cuma untuk "diringkas" atau "dianalisis", kecuali sudah dipastikan lewat akun dengan kontrol privasi jelas (Business/Enterprise) dan ada persetujuan dari pihak terkait.
Data kontrak/klien yang terikat NDA atau perjanjian kerahasiaan.
Kalau perlu tetap memproses data semacam ini, samarkan dulu (mis. ganti nama perusahaan/klien asli jadi "Klien A", hapus nomor identitas dan detail kesehatan) sebelum dikirim ke AI.
Catatan untuk peserta yang developer: kredensial teknis seperti API key, token akses, dan source code proprietary juga tidak boleh masuk ke prompt AI eksternal — sama prinsipnya, cuma audiensnya lebih spesifik.
Fakta Penting: Data Kamu vs Training Model
Ini yang sering tidak disadari pengguna baru:
Akun personal (Free, Plus, Pro): secara default, data yang kamu ketik dipakai untuk melatih model ("Improve the model for everyone"). Ini harus dimatikan manual di Settings → Data Controls.
Akun Business/Team/Enterprise: secara default, data tidak dipakai untuk training.
Riwayat chat (history) dan opt-out training adalah dua pengaturan yang berbeda — mematikan salah satu tidak otomatis mematikan yang lain.
Implikasi untuk kerja vendor/agency: kalau kamu mengetik data klien di akun personal tanpa mematikan toggle training, data itu berpotensi jadi bahan pelatihan model pihak ketiga. Ini risiko kontraktual, bukan cuma risiko teknis.
Setting Chat Privat/Sementara di Tiap Platform
Selain toggle training di atas, ketiga platform punya mode chat privat khusus untuk percakapan yang tidak boleh masuk riwayat atau memori. Ini pelengkap, bukan pengganti, dari langkah menyamarkan data di atas.
Platform
Nama Fitur
Cara Aktifkan
Efek
ChatGPT
Temporary Chat
Mulai chat baru → pilih opsi Temporary
Tidak masuk riwayat, tidak dipakai training selama masih temporary, tidak menambah Memory. Kalau tidak disimpan manual, chat hilang begitu ditutup dan tidak bisa dibuka lagi.
Claude
Incognito Chat
Chat baru → klik ikon ghost di kanan atas
Tidak masuk riwayat, tidak dipakai training, tidak masuk ke Memory. Tidak bisa diubah jadi chat biasa, dan tidak bisa dipakai di dalam Projects.
Gemini
Temporary Chat
Buka menu chat baru → pilih Temporary Chat
Tidak disimpan permanen, tidak dipakai training, tidak dipakai untuk personalisasi.
Catatan penting — ini bukan "menghilang total": ketiga platform tetap menyimpan salinan sementara di server untuk keperluan keamanan/anti-abuse, sebelum benar-benar dihapus:
- ChatGPT: bisa disimpan hingga 30 hari.
- Claude: disimpan 30 hari (bisa lebih lama untuk akun Enterprise).
- Gemini: disimpan 72 jam.
Jadi mode ini tepat untuk mencegah data masuk riwayat/memori/training, tapi bukan jaminan data langsung lenyap dari server pada detik itu juga. Untuk data yang benar-benar sensitif (kesehatan, kontrak klien), tetap jangan diketik sama sekali — bukan cuma diandalkan ke mode privat ini.
Desktop App vs Browser — Mana yang Lebih Aman?
Asumsi umum "install aplikasi supaya lebih praktis" perlu diluruskan — dari sisi keamanan data, justru browser lebih terkontrol untuk kerja sensitif:
Aspek
Browser (Web)
Desktop App
Cakupan akses
Terbatas pada tab yang aktif
Fitur seperti riwayat aktivitas (computer use) memakai izin sistem yang bisa membaca aktivitas di seluruh aplikasi, bukan cuma di dalam AI itu sendiri
Kontrol organisasi (IT)
Bisa diawasi lewat kebijakan browser standar perusahaan
Browser bawaan di dalam app untuk fitur agen kerja bisa berjalan di luar kebijakan IT kantor
Penyimpanan lokal
Umumnya tidak menyimpan log aktivitas di perangkat
Beberapa fitur menyimpan file memori/log secara lokal di disk
Rekomendasi
Gunakan untuk kerja klien / data sensitif
Gunakan untuk eksplorasi personal; hindari untuk data proyek klien sampai ada kebijakan IT yang jelas
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Langkah Mitigasi Praktis (Checklist)
Cek dan matikan toggle training di akun personal (Settings → Data Controls), atau gunakan akun Business/Team untuk kerja klien.
Samarkan identitas/nama sensitif sebelum menempel data ke prompt.
Pakai mode chat privat (Temporary Chat / Incognito) untuk percakapan yang tidak perlu tersimpan — tapi tetap samarkan data sensitif, jangan mengandalkan mode ini saja.
Untuk data klien, gunakan versi browser, bukan desktop app, kecuali ada kebijakan IT yang mengatur.
Review berkala isi memory AI (dibahas di bagian 05) — hapus data lama yang sudah tidak relevan atau sensitif.
Tahapan Pelaksanaan
Sampaikan prinsip dasar dan daftar data yang harus dihindari (3').
Jelaskan fakta training data + bedanya akun personal vs bisnis (3').
Paparkan setting chat privat/sementara di tiap platform (3').
Paparkan tabel desktop vs browser (3').
Bagikan checklist mitigasi, minta peserta cek toggle training + coba aktifkan mode privat di akun masing-masing secara langsung (3').
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta mampu:
Menyebutkan data seperti apa yang aman/tidak aman dikirim ke AI eksternal.
Menjelaskan perbedaan risiko antara memakai AI lewat browser vs desktop app.
Menerapkan minimal 2 langkah mitigasi konkret sebelum mengetik data ke AI.
Capaian Bagian Ini
Konsep: Data yang diketik ke AI eksternal berpotensi dipakai untuk training dan tersimpan di server pihak ketiga. Mode chat privat mengurangi risiko ini, tapi tidak menghapus data secara instan. Data dibagi tiga zona (boleh, hati-hati, dilarang), dan kalau ragu, jangan masukkan. *
Mekanisme: Risiko berbeda tergantung jenis akun (personal vs bisnis), jenis akses (browser vs desktop app), dan mode chat yang dipakai (biasa vs privat/sementara).
Indikator Keberhasilan
Setiap peserta berhasil mengecek (dan jika perlu, mematikan) toggle training, serta mencoba mengaktifkan mode chat privat di akun masing-masing sebelum bagian ini selesai.
Jangkar penutupAman dulu, baru produktif. Sekarang kita masuk praktik langsung: mengatur ChatGPT supaya kerja jadi lebih cepat.
Materi 1 · Leading Self 1 — Materi Dasar AI
05Praktik Dasar Penggunaan ChatGPT
Durasi20 menit
Slide terkait
Alur Materi 1
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan
Dua fitur ChatGPT ini paling berdampak pada produktivitas harian, tapi paling sering tidak dipakai pengguna baru: Custom Instructions (profil statis, diisi manual sekali) dan Memory (catatan dinamis, terbentuk otomatis dari percakapan). Begitu keduanya terisi, prompt bisa jauh lebih singkat karena AI sudah "kenal" penggunanya — tidak perlu mengulang konteks yang sama tiap chat baru.
Bagian C — Minta Bantuan Menggali Kebutuhan Sendiri: Framework GALI (5')
Masalah yang sering terjadi: peserta sudah tahu framework SIAP (bagian 03), tapi tetap bingung — karena belum tahu apa Situasi/Instruksi/Acuan/Pola-nya sendiri. Bukan masalah cara menulis prompt, tapi belum tahu apa yang mau ditanyakan. Solusinya: minta AI membantu menggali kebutuhan itu duluan, sebelum minta jawaban akhir.
Konsep: Alih-alih langsung minta AI menjawab, arahkan dulu AI untuk bertanya balik ke kita — supaya kita "digali" informasinya selangkah demi selangkah, seperti wawancara singkat.
Huruf
Elemen
Isi
G
Gambarkan Tujuan
Sampaikan tujuan akhir secara umum, walau belum detail. Tidak apa kalau masih kabur.
A
Ajak AI Bertanya Balik
Tambahkan instruksi eksplisit: minta AI menanyakan satu per satu hal yang perlu ia tahu, jangan langsung menjawab.
L
Lengkapi Bertahap
Jawab pertanyaan AI satu-satu, jangan buru-buru menjawab semuanya sekaligus.
I
Iterasi Sampai Cukup
Ulangi tanya-jawab sampai AI merasa informasinya cukup, baru minta ia menyusun hasil akhir.
Contoh prompt pembuka GALI:
"Saya mau bikin laporan bulanan buat atasan saya, tapi saya belum tahu detailnya harus seperti apa. Sebelum kamu bantu, tanya saya dulu satu per satu hal yang perlu kamu ketahui — jangan langsung kasih template."
Kaitan dengan SIAP: GALI dan SIAP menyelesaikan masalah yang berbeda. Pakai SIAP kalau kamu sudah tahu Situasi/Instruksi/Acuan/Pola-nya sejak awal. Pakai GALI kalau belum tahu — hasil obrolan GALI itulah yang nantinya jadi bahan mengisi SIAP.
Praktik: peserta pilih satu kebutuhan kerja yang mereka sendiri belum tahu cara mulainya, coba jalankan GALI, dan catat pertanyaan-pertanyaan yang diajukan AI.
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Bagian A — Custom Instructions (5')
Konsep: Fitur untuk memberi tahu AI siapa kita dan bagaimana kita mau dijawab — berlaku otomatis di setiap percakapan baru. Analoginya: mengisi riwayat singkat ke asisten baru sebelum ia mulai bekerja.
Kolom 1 — "What would you like ChatGPT to know about you?": isi peran/profesi, industri, konteks kerja. Contoh: "Saya developer full-stack yang mengerjakan proyek klien di bidang retail dan logistik."
Kolom 2 — "How would you like ChatGPT to respond?": isi gaya jawaban yang diinginkan. Contoh: "Jawaban ringkas, langsung ke poin, pakai bahasa Indonesia santai tapi profesional, hindari basa-basi."
Simpan, lalu buka chat baru untuk membuktikan AI langsung menyesuaikan gaya jawabannya.
Praktik: Peserta mengisi Custom Instructions masing-masing dengan konteks kerja sendiri.
Bagian B — Memory (5')
Konsep: Fitur AI untuk menyimpan fakta dan preferensi dari percakapan sebelumnya secara otomatis, tanpa perlu diulang tiap chat baru.
Beda dengan Custom Instructions: Custom Instructions itu "form biodata" yang diisi manual sekali; Memory itu "catatan" yang AI tulis sendiri sambil berjalan, berdasarkan interaksi.
Bisa juga minta AI langsung di chat: "Tolong ingat bahwa saya biasa bikin laporan mingguan tiap Jumat."
Hapus entri memory yang sudah tidak relevan secara berkala — sesuai prinsip keamanan data di bagian 04.
Demo Live — Memory dalam Praktik:
Di chat A, sampaikan konteks kerja (mis. "saya PM di proyek X, tim saya 5 orang").
Buka chat baru (B), tanya sesuatu yang berkaitan — tunjukkan AI masih "ingat".
Jelaskan kaitannya dengan halusinasi: semakin lengkap konteks relevan yang tersedia (lewat memory/profil/upload dokumen), semakin kecil risiko AI mengarang jawaban.
Bagian D — Gabungkan dengan SIAP (5')
Setelah Custom Instructions dan Memory terisi, prompt tidak perlu mengulang konteks "Situasi" tiap kali — AI sudah tahu. Peserta cukup fokus ke Instruksi, Acuan, Pola Output.
Sebelum (tanpa profil terisi):"Kamu asisten HR di perusahaan retail. Buatkan surat peringatan..."Sesudah (profil sudah terisi):"Buatkan surat peringatan untuk karyawan yang sering terlambat. Nada tegas, maksimal 200 kata, format resmi." — AI sudah tahu perannya dari Custom Instructions.
Praktik akhir: peserta menulis satu prompt nyata dari pekerjaannya — pakai GALI dulu kalau belum jelas kebutuhannya, baru rapikan jadi SIAP — lalu menjalankannya.
Tahapan Pelaksanaan
Jelaskan dan praktikkan Custom Instructions (5').
Jelaskan dan demo Memory (5').
Perkenalkan framework GALI dan praktik singkat (5').
Gabungkan ke satu prompt praktik nyata pakai GALI + SIAP (5').
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta mampu secara mandiri:
Mengatur Custom Instructions di ChatGPT.
Memahami dan mengelola fitur Memory.
Meminta AI membantu menggali kebutuhan sendiri lewat framework GALI, saat belum tahu harus mulai dari mana.
Menggabungkan Custom Instructions + Memory + framework SIAP menjadi satu alur kerja yang lebih cepat.
Capaian Bagian Ini
Konsep: Perbedaan fungsi Custom Instructions (statis, manual) vs Memory (dinamis, otomatis) vs GALI (cara menggali kebutuhan sendiri lewat AI).
Mekanisme: Custom Instructions dan Memory menambah konteks yang diproses AI sebelum menyusun jawaban. GALI menyelesaikan masalah yang berbeda: dipakai saat penggunanya sendiri belum tahu apa yang perlu disampaikan — AI diarahkan bertanya dulu, bukan langsung menjawab.
Indikator Keberhasilan
Mayoritas peserta berhasil mengisi Custom Instructions, menjalankan satu sesi GALI, dan menjalankan minimal satu prompt praktik nyata sebelum bagian ini berakhir.
Jangkar penutupProfil + memory + GALI (saat belum tahu mau nanya apa) + SIAP (saat sudah tahu) = alur kerja yang bisa langsung dipakai besok. Sekarang kita rangkum semuanya.
Materi 1 · Leading Self 1 — Materi Dasar AI
06Penutup dan Rencana Tindak Lanjut
Durasi5 menit
Slide terkait
Alur Materi 1
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan
Rangkuman alur sesi (bacakan cepat, satu napas):
AI menyusun jawaban dengan menebak pola dari data (01) → platform berbeda-beda tapi prinsipnya sama (02) → prompt yang jelas pakai SIAP menghasilkan jawaban yang jelas (03) → tapi tetap jaga data yang masuk ke AI, cek toggle training (04) → isi profil dan memory supaya AI makin "kenal" kita dan makin sedikit ngarang (05) → tetap verifikasi apa pun yang penting — karena AI membantu, manusia memutuskan. *
Tujuh Praktik Baik Penggunaan AI
Isi Custom Instructions sekali di awal — hemat waktu di semua chat berikutnya.
Mulai prompt dengan Situasi singkat (kalau belum lewat profil).
Pecah tugas besar jadi beberapa prompt kecil, bukan satu prompt raksasa.
Minta AI bertanya balik kalau instruksi dirasa kurang jelas.
Selalu verifikasi data/fakta/angka penting sebelum dipakai — jangan copy-paste mentah. Kamu yang bertanggung jawab atas apa yang kamu kirim, bukan AI. *
Tinjau dan bersihkan memory secara berkala, terutama data sensitif klien.
Rencana Pengembangan Lanjutan
Leading Self 2A (tersedia): AI untuk analisa data dan kepemilikan hasil — pertanyaan penutup sesi ini ("Bisakah kita selalu mempercayai hasil AI? Tidak selalu") dijawab di sana lewat prinsip OWN: periksa, pisahkan fakta dari asumsi, kirim kesimpulanmu sendiri. *
Leading Self 2B (usulan): Kustomisasi asisten AI (Custom GPT/Gems/Projects) sesuai peran kerja masing-masing.
Modul lanjutan yang sudah tersedia: lihat 07 — Framework Data Analyst untuk peserta yang bekerja dengan data dan laporan.
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Tahapan Pelaksanaan
Bacakan rangkuman alur (1').
Sampaikan tujuh praktik baik (2').
Berikan tugas praktik: peserta mencoba satu prompt nyata dari pekerjaannya menggunakan semua yang dipelajari (1').
Minimal satu peserta menyampaikan pertanyaan atau rencana konkret penerapan AI di pekerjaannya.
Evaluasi Keberhasilan Sesi (opsional, untuk fasilitator)
Kuis singkat (5 pertanyaan) — cara kerja AI, token/prompt, komparasi platform, keamanan data.
Tugas praktik — peserta submit tangkapan layar hasil prompt SIAP yang disusun mandiri.
Evaluasi mandiri lanjutan — cek ulang setelah satu minggu untuk melihat konsistensi pemakaian.
Selesai. Total durasi: 90 menit (00–06).
Materi 1 · Leading Self 1 — Materi Dasar AI
07Modul Lanjutan: Framework DATA untuk Analisis Data
Durasi30-45 menit (opsional)PrasyaratPeserta sudah menyelesaikan bagian 00–06, minimal paham framework SIAPAudiensPeserta yang pekerjaannya melibatkan pengolahan data dan penulisan laporan (bukan pemula umum)
Slide terkait
Alur Materi 1
1
Penjelasan
Konsep & alasan di balik bagian ini
Kenapa Modul Ini Perlu Terpisah
Framework SIAP di bagian 03 dirancang untuk instruksi umum. Untuk kerja analisis data, ada masalah tambahan yang lebih berisiko: AI cenderung mengisi kekosongan data dengan asumsi yang kedengarannya masuk akal, padahal mengarang — ini yang disebut halusinasi. Untuk laporan yang datanya harus akurat (finansial, operasional, laporan ke klien), risiko ini tidak bisa diselesaikan dengan SIAP saja. Perlu aturan tambahan yang secara eksplisit melarang AI berasumsi dan mewajibkan AI mengutip sumber datanya sendiri.
Framework: DATA
Huruf
Elemen
Instruksi ke AI
D
Data dulu
Lampirkan data mentah/sumber asli sebagai bahan analisis — jangan andalkan AI mengingat atau menebak angka dari memori/percakapan sebelumnya
A
Aturan larangan mengarang
Instruksikan eksplisit: "Jangan berasumsi. Kalau informasi tidak ada di data yang diberikan, katakan tidak ada — jangan diisi dengan estimasi tanpa disebutkan sebagai estimasi"
T
Tanya balik jika kurang jelas
Instruksikan: "Kalau ada data yang kosong, ambigu, atau kontradiktif, tanyakan ke saya dulu sebelum menyimpulkan"
A
Audit sumber setiap klaim
Instruksikan: "Untuk setiap insight/angka di laporan, sebutkan baris, kolom, atau bagian data mana yang jadi sumbernya"
Kenapa Setiap Aturan Ini Penting
Larangan mengarang eksplisit — tanpa ini, AI secara default akan "menghaluskan" kekosongan data dengan asumsi yang tidak ditandai sebagai asumsi. Ini sumber halusinasi paling umum di kerja data.
Bertanya balik — mencegah AI mengambil jalan pintas menyimpulkan dari data yang sebenarnya tidak cukup.
Audit sumber (cite per klaim) — memaksa AI "menunjukkan kerjanya". Kalau AI tidak bisa menunjukkan baris sumbernya, itu sinyal klaim tersebut kemungkinan dikarang.
Istilah dan satuan tidak diubah — laporan yang mengganti istilah asli (misal "revenue" jadi "pendapatan", atau membulatkan Rp 1.234.567 jadi "sekitar Rp 1,2 juta") tanpa disebutkan bisa menyesatkan pembaca laporan yang membandingkan dengan sumber asli.
Batas yang Tetap Harus Dipegang
Framework ini mengurangi risiko halusinasi, tapi tidak menghilangkannya sepenuhnya. AI tetap bisa salah membaca pola meskipun sudah dilarang berasumsi. Laporan hasil AI untuk keputusan berisiko (finansial, kontrak, kepatuhan) tetap wajib direview manusia sebelum dipakai — ini prinsip yang sama dari bagian 04, hanya diterapkan lebih ketat karena taruhannya lebih tinggi.
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Contoh Prompt Lengkap (Siap Pakai)
Berikut data penjualan Q3 (terlampir). Analisis tren bulanan HANYA
berdasarkan data ini — jangan menambahkan asumsi, data historis, atau
informasi dari luar lampiran.

Aturan kerja:
1. Kalau ada baris yang kosong, tidak konsisten, atau tidak jelas satuannya,
   tanya saya dulu sebelum menyimpulkan apa pun.
2. Untuk setiap insight atau angka yang disebutkan, cantumkan baris/kolom
   sumbernya di dalam tanda kurung.
3. Kalau ada anomali (misal lonjakan atau penurunan tidak wajar), tandai
   secara terpisah dan minta konfirmasi saya sebelum dimasukkan ke
   kesimpulan akhir.
4. Gunakan istilah dan satuan yang sama persis seperti di data asli —
   jangan mengganti istilah dengan sinonim atau membulatkan angka tanpa
   menyebutkan bahwa itu pembulatan.
5. Tutup laporan dengan daftar bagian data yang TIDAK cukup untuk
   dianalisis, jika ada.

Format output: ringkasan eksekutif (maks 5 poin) + tabel pendukung.
Praktik
Peserta menyiapkan satu set data kerja nyata (spreadsheet/CSV/tabel kecil).
Jalankan dulu prompt analisis tanpa framework DATA — amati apakah AI membuat asumsi tanpa disebutkan.
Jalankan ulang dengan framework DATA — bandingkan: apakah AI bertanya balik, apakah tiap klaim ada sitasi sumbernya.
Diskusikan: bagian mana dari laporan pertama yang berpotensi menyesatkan kalau langsung dipakai tanpa verifikasi.
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah modul ini, peserta mampu:
Menyusun instruksi yang membatasi AI hanya bekerja dari data yang diberikan, tidak menambah dari luar.
Meminta AI mengutip bagian data spesifik yang mendukung setiap klaim di laporannya.
Mengenali kapan AI seharusnya bertanya balik, bukan menyimpulkan sendiri.
Melakukan verifikasi silang sebelum laporan AI dipakai sebagai keputusan.
Capaian Modul Ini
Konsep: Halusinasi pada kerja data terjadi karena AI mengisi kekosongan dengan asumsi yang tidak ditandai.
Mekanisme: Instruksi eksplisit (larangan asumsi, wajib tanya balik, wajib sitasi sumber) mengecilkan ruang AI untuk mengarang, tapi tidak menggantikan verifikasi manusia.
Indikator Keberhasilan
Peserta bisa menunjukkan minimal satu perbedaan konkret antara hasil laporan sebelum dan sesudah memakai framework DATA.
Rujukan silang: Bagian 03 — Dasar Prompting untuk framework SIAP, dan 04 — Keamanan Data untuk aturan data sensitif yang tetap berlaku saat melampirkan data ke AI.
Materi 1 · Leading Self 1 — Materi Dasar AI
08Panduan Bergambar: Keamanan ChatGPT
DurasiBacaan mandiri (opsional, ±15 menit)
Slide terkait
Alur Materi 1
1
Penjelasan
Konsep & alasan di balik bagian ini
Satu halaman, hanya bagian yang punya gambar aslinya: tempat setting training, Temporary Chat, Memory, dan apa yang bisa dilihat admin workspace. Kondisi per Oktober 2026; nama menu bisa berbeda antar plan, wilayah, dan versi aplikasi.
Training (Settings → Data controls): boleh tidaknya chat dipakai memperbaiki model OpenAI.
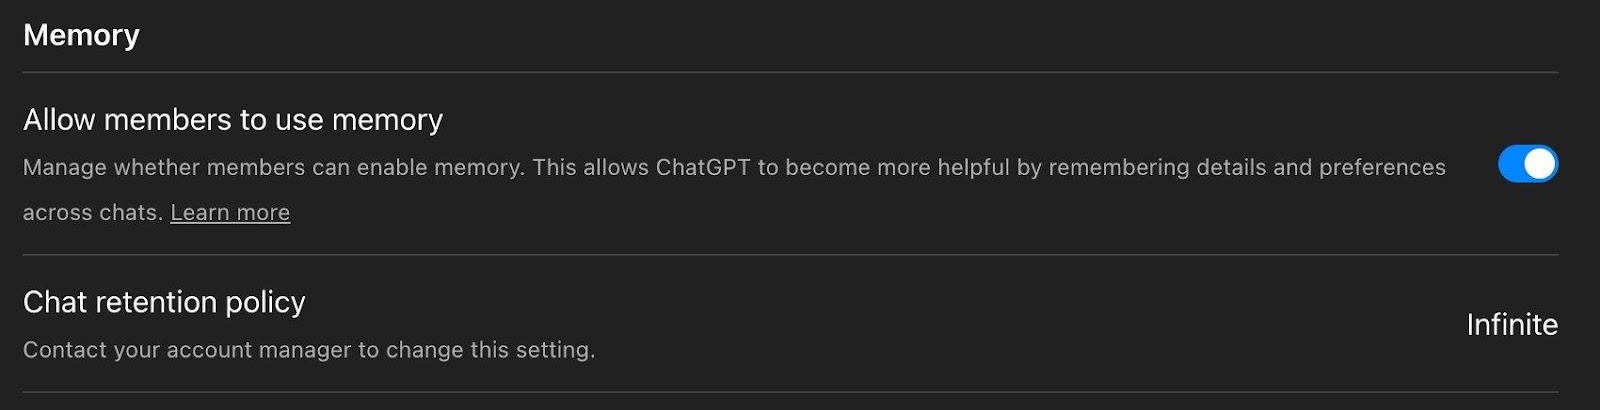
Memory (Settings → Personalization → Memory): boleh tidaknya ChatGPT mengingat kamu antar-chat.
Riwayat chat: chat tersimpan di akun sampai kamu hapus atau kebijakan workspace menghapusnya.
Matikan training tidak menghapus chat. Matikan Memory tidak menghapus chat. Hapus chat tidak otomatis menghapus saved memory. Akun personal (Free, Plus, Pro) ikut melatih model bila saklarnya aktif, sedangkan Business, Enterprise, dan Edu tidak dipakai melatih secara default.
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Langkah 1 — Matikan Pemakaian Chat untuk Training
Buka menu akun, pilih Settings, lalu Data controls. Di HP: sidebar → ikon profil → Data controls.
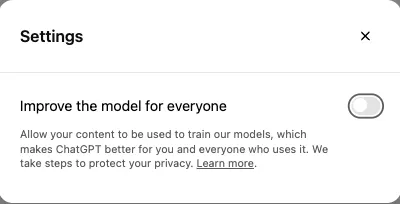
Matikan Improve the model for everyone, lalu Done.
Ingat: memberi jempol atau feedback pada jawaban bisa mengirim seluruh percakapan itu untuk training.
Gambar tidak termuat (butuh internet). Buka sumbernya: OpenAI Help Center
Toggle Improve the model for everyone dalam posisi mati. Sumber gambar: OpenAI Help Center.
Langkah 2 — Pakai Temporary Chat untuk Hal Sensitif
Temporary Chat itu tidak disimpan, bukan dihapus:
Tidak masuk riwayat, tidak membuat memory, dan tidak dipakai melatih model selama masih temporary.
OpenAI bisa menyimpan salinan hingga 30 hari untuk keamanan.
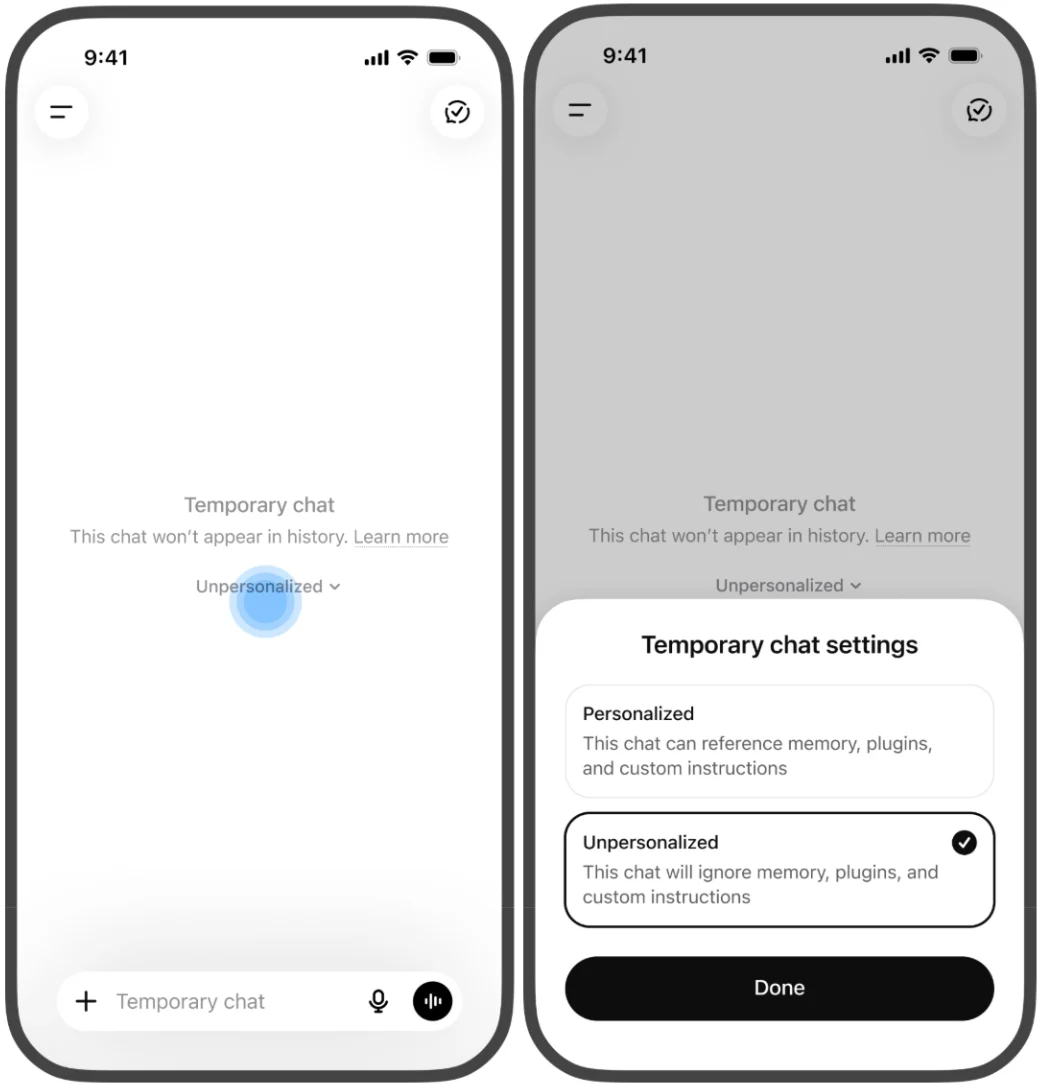
Pilih Personalized (memakai memory dan instruksi) atau Unpersonalizedsebelum pesan pertama.
Menyimpan temporary chat mengubahnya jadi chat biasa dan ikut aturan akunmu.
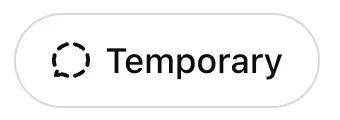
Gambar tidak termuat (butuh internet). Buka sumbernya: OpenAI Help Center
Chat baru → tombol Temporary di kanan atas. Sumber gambar: OpenAI Help Center.
Gambar tidak termuat (butuh internet). Buka sumbernya: OpenAI Help Center
Di HP: pilih Personalized atau Unpersonalized sebelum pesan pertama. Sumber gambar: OpenAI Help Center.
Langkah 3 — Lihat dan Hapus Memory dengan Benar
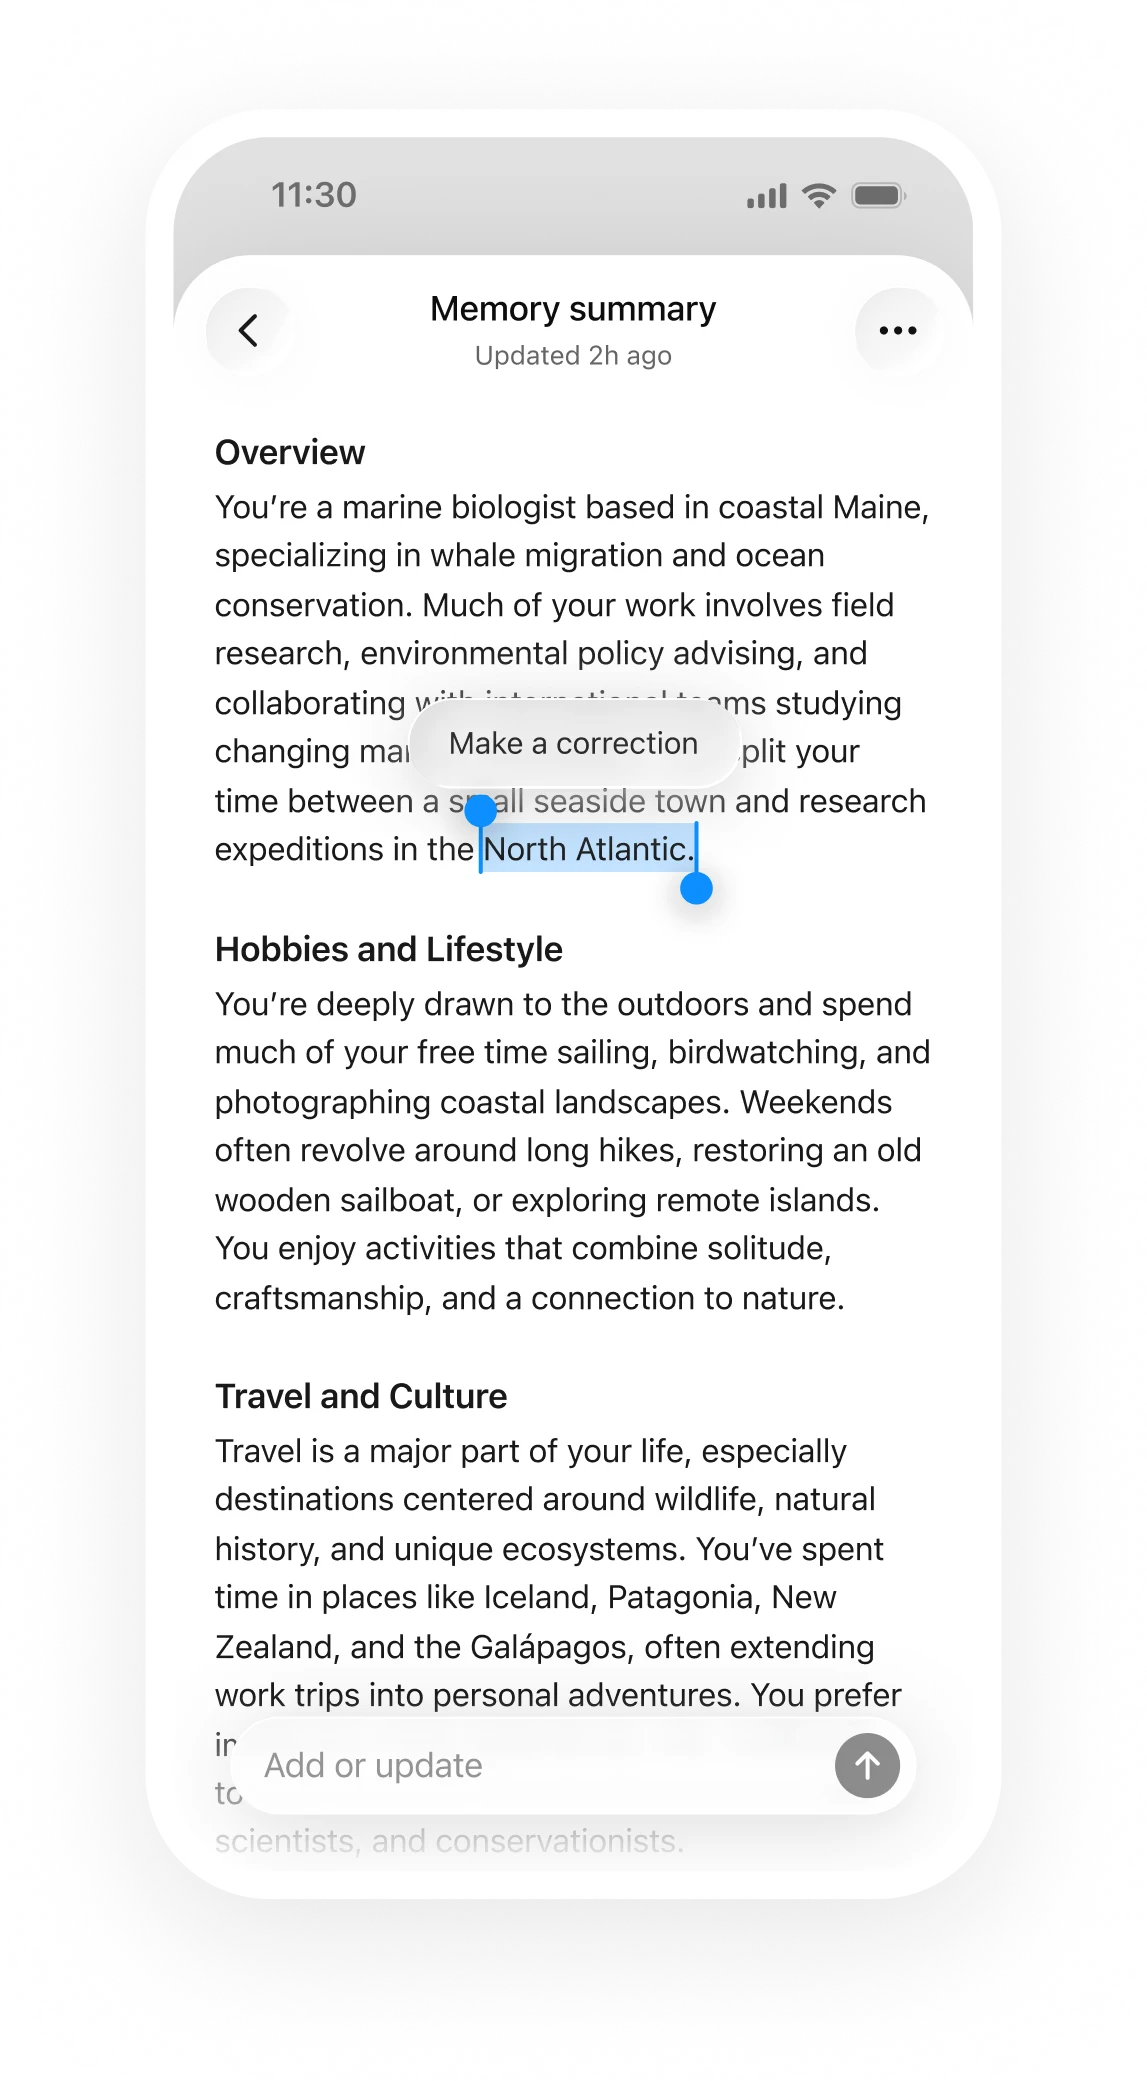
Buka Settings → Personalization → Memory, baca memory summary, dan koreksi yang salah. Atau tanya di chat: "Apa yang kamu ingat tentang saya?"
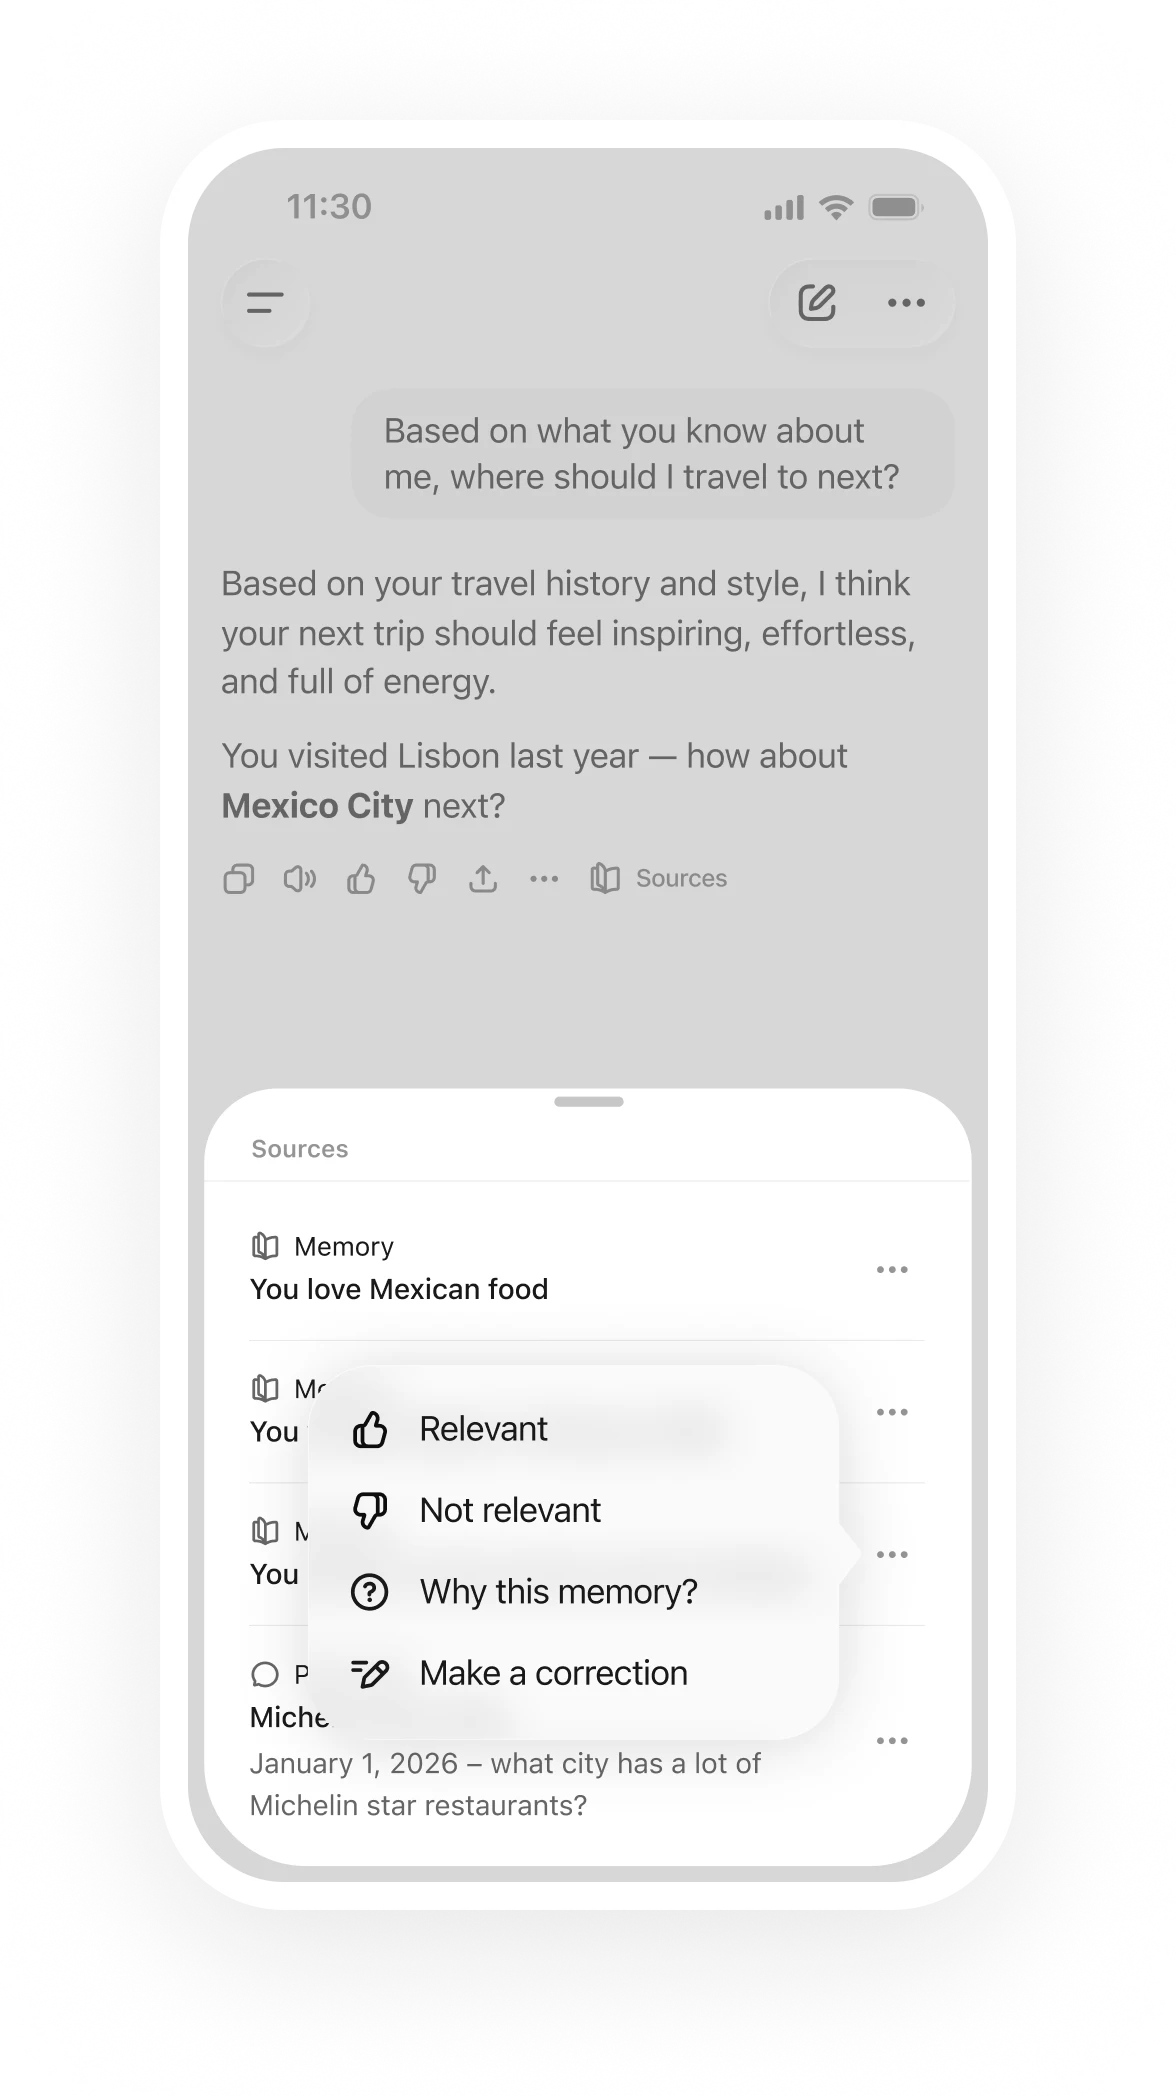
Ringkasan itu tidak memuat semua detail yang diingat. Lihat juga panel Sources di bawah jawaban.
Hapus memory saja belum cukup, hapus sumbernya: Delete and turn off memory menghapus isi summary dan mematikan Memory, tetapi chat lama tetap ada. Saved memory tersimpan terpisah, jadi hapus keduanya.
Reference chat history dimatikan: ingatan dari chat lama dijadwalkan terhapus dalam 30 hari.
"Don't mention this again" hanya mengurangi penyebutan, sumber aslinya tidak terhapus.
Gambar tidak termuat (butuh internet). Buka sumbernya: OpenAI Help Center
Memory summary dan menu tiga titik (Delete and turn off memory). Sumber gambar: OpenAI Help Center.
Gambar tidak termuat (butuh internet). Buka sumbernya: OpenAI Help Center
Sources di bawah jawaban menunjukkan memory atau chat yang dipakai. Sumber gambar: OpenAI Help Center.
Langkah 4 — Pahami yang Bisa Dilihat Admin Workspace
Anggap akun kantor itu terlihat.
Jenis akun
Siapa yang bisa melihat
Catatan
Personal (Free, Go, Plus, Pro)
Atasan tidak punya jalur admin
Chat terhubung ke akunmu dan OpenAI, bukan ke perusahaan
Business
Dua halaman OpenAI berbunyi berbeda
Satu halaman bilang admin bisa lihat dan ekspor, FAQ bilang tidak otomatis. Anggap bisa
Enterprise dan Edu
Admin punya jalur audit resmi
Audit log percakapan dan GPT lewat Compliance API
Di Enterprise dan Edu, menghapus chat tidak langsung hilang dari audit:
Chat yang dihapus user tetap bisa diambil lewat Compliance API sampai 30 hari.
Temporary Chat tetap tersedia di Compliance API selama 30 hari, apa pun retensi workspace.
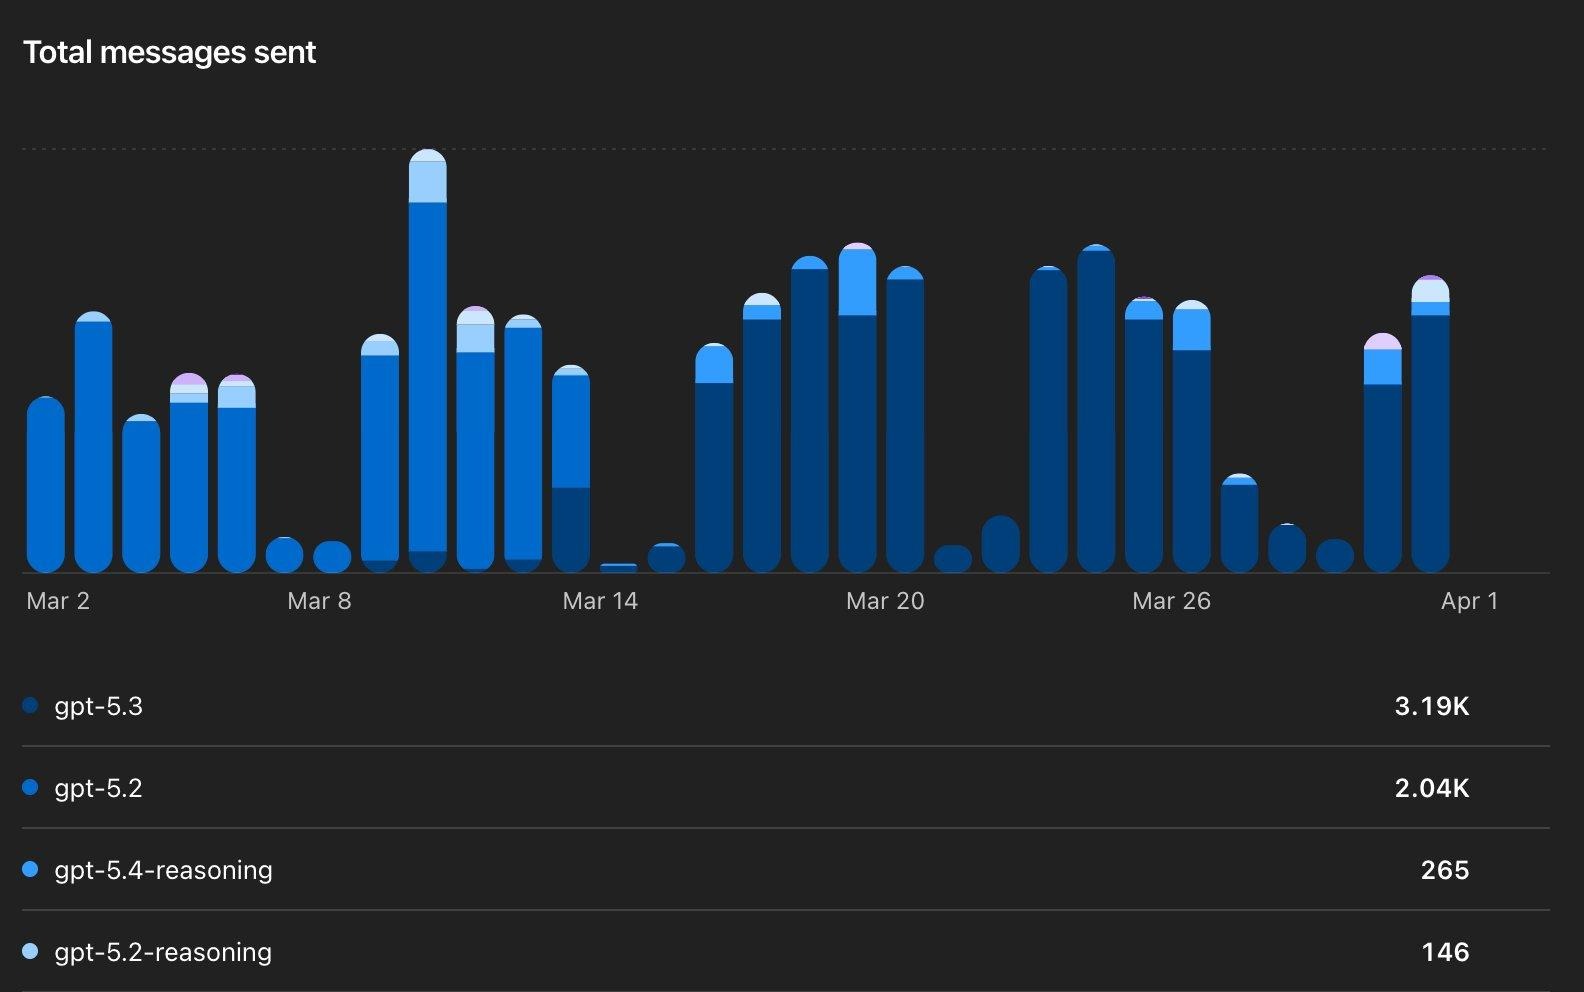
Dasbor analitik Enterprise: jumlah pesan per model, bukan isi percakapan. Sumber gambar: Harmonic Security, 2026.
Dasbor analitik menunjukkan pola (jumlah pesan, model, fitur yang dipakai), bukan percakapan. Isi percakapan hanya lewat jalur terpisah: Compliance API atau ekspor admin. Gambar admin dan analitik di atas dari panduan pihak ketiga (Harmonic Security), bukan dari OpenAI.
Checklist 5 Menit
[ ] Data controls: Improve the model for everyone mati.
[ ] Memory: sudah dibaca, yang salah atau sensitif dihapus beserta chat asalnya.
[ ] Data sensitif (kontrak, data klien, angka internal) hanya lewat Temporary Chat atau tidak sama sekali.
[ ] Shared links dicek di Settings → Data controls → Shared links → Manage.
Jangkar penutupMatikan yang boleh dimatikan, pisahkan yang sensitif, dan anggap akun kantor selalu terlihat.
Materi 2 · Leading Self 2A — Analisa Data dengan AI
Pengantar & Daftar Isi
Slide terkait
Alur Materi 2
1
Penjelasan
Konsep & alasan di balik bagian ini
Versi: 1.1.61 · 2026-10-15 · riwayat perubahan di VERSIONS.md (folder induk)
Materi lanjutan dari Leading Self 1, fokus pada penggunaan AI untuk mengolah data, menemukan insight, menyusun laporan/presentasi, dan memvalidasi hasilnya. Total durasi inti: 90 menit (~25% teori, ~75% praktik).
Prasyarat wajib: peserta sudah menyelesaikan Leading Self 1 — paham framework SIAP, GALI, DATA, dan prinsip keamanan data. Sesi ini tidak mengulang penjelasan dasar tersebut.
OLAH dibangun di atas tiga framework dari Leading Self 1 — bukan pengganti, dan dilengkapi satu prinsip lintas-tahap, OWN (AI membantu, manusia memutuskan, pengirim memiliki hasilnya): *
(Opsional) ChatGPT desktop app untuk mode Work — panel skill tambahan (Data Analytics, Validate Data, Visualize Data, dll) bonus kalau akun punya akses; wajib dites H-1 sebelum sesi.
Catatan Kritis untuk Fasilitator
Fitur Skills tambahan berubah cepat dan resminya untuk akun Business/Enterprise/Edu — jangan asumsikan sama seperti dokumentasi ini tanpa dites ulang.
Jangan pernah pakai data klien asli untuk demo di depan kelas.
Porsi praktik 75% berarti risiko molor tinggi — time-box ketat per segmen.
Konsep OWN (bagian 01, 04, 05) diadaptasi dari materi SOPRA AI@Work Sesi 2. Durasi bagian tidak berubah; kalau molor di 05, potong contoh kasus fakta vs asumsi, bukan uji OWN. *
3
Target
Apa yang harus dicapai & cara mengukurnya
Output Pembelajaran
Peserta mampu menggunakan AI untuk mempercepat proses olah data → analisa → insight → presentasi/report, dengan tetap memahami dan memvalidasi data.
Materi 2 · Leading Self 2A — Analisa Data dengan AI
00Pembukaan dan Setup Tools
Durasi8 menit
Slide terkait
Alur Materi 2
1
Penjelasan
Konsep & alasan di balik bagian ini
Prasyarat
Sesi ini lanjutan langsung dari Leading Self 1 — peserta wajib sudah paham:
Kalau ada peserta yang belum ikut Leading Self 1, jangan lanjutkan tanpa mereka membaca minimal keempat bagian di atas — sesi ini berjalan cepat dan berasumsi semua istilah itu sudah dikenal.
Penjelasan
Leading Self 1 fokus ke penggunaan AI untuk kerja individual sehari-hari. Sesi ini ("Leading Others") naik satu tingkat: memakai AI untuk mengolah data, menghasilkan insight, dan menyusun laporan/presentasi yang bisa dipertanggungjawabkan ke orang lain — atasan, tim, atau klien. Karena outputnya dikonsumsi orang lain, standar akurasi dan validasinya harus lebih ketat dari sekadar kerja personal.
Porsi sesi ini: ~25% teori, ~75% praktik. Kalau di Leading Self 1 kita banyak menjelaskan dulu baru coba, di sini kebalikannya — konsep dijelaskan singkat, sisanya langsung kerja dengan data.
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Cek Akun Sebelum Mulai
Rekomendasi minimum: ChatGPT Plus/Pro. Semua praktik di sesi ini didesain berjalan di paket ini lewat fitur Advanced Data Analysis (upload file, analisis, bikin grafik).
Akun Free/Go: tetap bisa ikut, tapi kena limit pemakaian lebih ketat (jumlah upload/pesan per periode). Sampaikan ini di awal supaya peserta tidak kaget kalau tiba-tiba dibatasi di tengah praktik.
Skill tambahan (Data Analytics, Validate Data, Visualize Data, dll — lihat bagian 01) resminya untuk akun Business/Enterprise/Edu. Ini bonus, bukan syarat. Kalau tidak muncul di akun peserta, seluruh praktik tetap bisa jalan pakai prompt manual.
Instal ChatGPT Desktop App (Opsional, untuk Fitur Work)
Buka chatgpt.com/features/desktop, unduh untuk Windows/Mac, sign in dengan akun yang sudah dicek di atas.
Buka mode Work (terpisah dari mode Chat biasa) — di sinilah kemungkinan panel skill tambahan muncul.
Cek lewat sidebar Plugins → tab Skills. Kalau kosong/tidak ada, lanjut saja pakai ChatGPT versi biasa (web atau desktop mode Chat) — tidak menghalangi praktik inti sesi ini.
Catatan fasilitator: fitur ini baru dan berubah cepat. Wajib dites H-1 di akun yang akan dipakai demo — jangan asumsikan sama seperti saat materi ini dibuat.
Siapkan Dataset Kerja
Siapkan satu file data (CSV/Excel) untuk dipakai sepanjang sesi 02–05 — bisa data kerja asli yang sudah dianonimkan, atau dataset contoh dari fasilitator sebagai cadangan.
Anonimkan dulu sesuai prinsip LS1 bagian 04: ganti nama perusahaan/klien asli, hapus data pribadi pihak ketiga, jangan pernah pakai data kesehatan asli.
Fasilitator siapkan dataset cadangan siap pakai — supaya peserta yang datanya sendiri bermasalah (terlalu besar, format aneh) tidak menyita waktu praktik yang sudah ketat.
Dataset Cadangan yang Sudah Disiapkan
File dataset_penjualan_retail_dummy.xlsx (satu folder dengan materi ini) siap dipakai langsung sebagai cadangan:
100% data sintetis (dibuat untuk latihan) — data penjualan retail dummy Juli–September 2026, 4 cabang, 4 kategori produk.
Sengaja mengandung masalah kualitas data (data kosong, inkonsistensi penulisan, anomali kuantitas, baris duplikat) — jangan dibersihkan dulu sebelum bagian 02.
Sheet kedua (Panduan & Jawaban) berisi daftar lengkap masalah yang ditanam — ini jawaban untuk fasilitator, jangan ditunjukkan ke peserta sebelum mereka selesai praktik Observasi.
Bagikan ke peserta hanya sheet pertama (Data Transaksi), atau minta mereka export/copy sheet itu saja kalau ingin menyembunyikan jawaban sepenuhnya.
Tahapan Pelaksanaan
Sampaikan hubungan sesi ini dengan Leading Self 1 dan gambaran porsi teori/praktik (1').
Cek plan akun peserta secara langsung, jelaskan implikasinya (1').
Praktik instal desktop app / cek fitur Work (5').
Pastikan setiap peserta punya dataset kerja yang siap dan sudah dianonimkan (1').
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta mampu:
Menjelaskan hubungan sesi ini dengan Leading Self 1.
Memastikan akun dan tools siap sebelum masuk praktik inti.
Menyiapkan satu dataset kerja yang aman untuk dipakai sepanjang sesi.
Capaian Bagian Ini
Peserta siap secara teknis (akun, tools, dataset) untuk masuk ke praktik inti tanpa hambatan di tengah jalan.
Indikator Keberhasilan
Setiap peserta punya akun yang sudah dicek dan satu dataset kerja yang siap dipakai sebelum bagian ini selesai.
Jangkar penutupTools siap, data siap. Sekarang kita kenalan sama alur kerjanya: OLAH.
Materi 2 · Leading Self 2A — Analisa Data dengan AI
01Framework OLAH: Alur Kerja Data ke Report
Durasi12 menit
Slide terkait
Alur Materi 2
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan
Framework yang dipelajari di Leading Self 1 (SIAP, GALI, DATA) dirancang untuk satu prompt sekali jalan. Kerja data yang berujung ke laporan/presentasi butuh beberapa tahap berurutan, bukan satu prompt ajaib. OLAH adalah rumah yang menaruh ketiga framework itu di tempat yang tepat pada tiap tahap.
Framework OLAH
Huruf
Tahap
Isi
Framework yang Dipakai
O
Observasi Data
Kenali struktur, kualitas, dan pola awal data — sebelum menyimpulkan apa pun
DATA (larang mengarang tentang data yang belum diperiksa)
L
Lacak Insight
Prompting terarah untuk menemukan insight yang benar-benar didukung data
SIAP + DATA (wajib sitasi sumber tiap klaim)
A
Atur jadi Presentasi
Susun insight jadi ringkasan eksekutif + visual untuk audiens
SIAP (Pola Output jadi kunci di tahap ini)
H
Hasil Divalidasi
Cek ulang angka kunci ke sumber asli sebelum dipakai/dikirim
DATA (audit sumber) + verifikasi manusia
Kenapa urutannya harus begini: melompat ke Insight (L) sebelum benar-benar Observasi (O) adalah penyebab paling umum laporan AI yang menyesatkan — AI (atau kita) menyimpulkan dari data yang polanya belum benar-benar dipahami. Melompat ke Presentasi (A) sebelum Validasi (H) berarti kesalahan yang belum ketahuan langsung dikirim ke audiens.
Pemetaan Tool: Inti vs Bonus
Sesi ini didesain berjalan penuh dengan fitur yang ada di semua akun ChatGPT Plus/Pro (Advanced Data Analysis: upload file, jalankan analisis, bikin grafik). Kalau akun peserta punya akses ke Skills tambahan (dicek di bagian 00), ini mempercepat prosesnya — tapi bukan syarat.
Tahap
Fitur Inti (wajib bisa jalan)
Bonus (kalau Skills muncul)
O — Observasi
Upload data, prompt manual pakai DATA untuk profil data
Skill Analyze Data Quality / Create Data Context
L — Insight
Prompt insight + wajib cite baris/kolom sumber
Skill Data Analytics
A — Presentasi
Minta chart (gambar) + ringkasan teks, susun manual
Skill Visualize Data + Data Analytics: Publish Artifact
H — Validasi
Checklist manual: cross-check ke file asli
Skill Validate Data
Peringatan penting untuk tahap A: kalau skill Publish Artifact dipakai (menerbitkan dashboard/laporan ke link publik seperti Vercel), jangan pernah publish data klien asli ke link publik — prinsip ini sama dengan LS1 bagian 04. Link publik berarti siapa pun yang punya link bisa akses, bukan cuma tim internal.
Lapisan OWN: Siapa yang Memiliki Hasilnya? *
OLAH menjawab bagaimana mengolah data dengan benar. Satu pertanyaan masih tersisa: siapa yang bertanggung jawab atas hasilnya? Jawabannya selalu manusia — AI menyusun draf, kamu yang memilikinya begitu hasilnya dikirim ke orang lain.
AI membantu, manusia memutuskan. AI boleh menganalisis, membandingkan, dan menyarankan — keputusan akhir tetap di tangan manusia.
Jangan teruskan output AI — teruskan kesimpulanmu. Meneruskan hasil mentah AI ke atasan/tim = melempar pekerjaan berpikir ke orang lain.
Kamu pemilik apa pun yang kamu kirim. Kalau salah, "kata AI" bukan jawaban; tanggung jawab ada pada pengirim.
OWN dipraktikkan konkret di dua tahap: A (setiap laporan wajib punya kesimpulan, tindakan, dan pemilik) dan H (uji kepemilikan sebelum kirim, plus batas keputusan yang tidak boleh diserahkan ke AI). Kerangka ini diadaptasi dari materi SOPRA AI@Work Sesi 2 (Think & Own).
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Tahapan Pelaksanaan
Jelaskan kenapa kerja data butuh framework bertahap, bukan satu prompt (3').
Paparkan tabel OLAH dan kaitannya dengan SIAP/GALI/DATA (4').
Paparkan tabel pemetaan tool inti vs bonus, tekankan peringatan publish data (3').
Perkenalkan 3 aturan OWN dan rumus Output AI + Dicek & Disesuaikan = Hasil Kerja (1'); detail dipraktikkan di bagian 04 dan 05. *
Cek pemahaman singkat: minta peserta sebutkan urutan OLAH tanpa melihat catatan (1').
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta mampu:
Menjelaskan 4 tahap framework OLAH dan urutan kerjanya.
Menjelaskan hubungan OLAH dengan SIAP, GALI, dan DATA yang sudah dipelajari di Leading Self 1.
Mengetahui tool mana yang dipakai di tiap tahap — inti maupun bonus.
Menyebutkan 3 aturan kepemilikan (OWN) yang berlaku di semua tahap: AI membantu, manusia memutuskan. *
Capaian Bagian Ini
Konsep: OLAH adalah alur kerja 4 tahap (Observasi → Lacak Insight → Atur Presentasi → Hasil Validasi) yang menempatkan SIAP/GALI/DATA pada tahap yang tepat.
Kepemilikan: Hasil AI baru menjadi hasil kerja setelah dicek dan disesuaikan manusia; pengirim adalah pemiliknya (OWN). *
Mekanisme: Melompati urutan (langsung ke insight tanpa observasi, atau langsung publish tanpa validasi) adalah sumber risiko utama laporan yang menyesatkan.
Indikator Keberhasilan
Mayoritas peserta bisa menyebutkan urutan OLAH dan menjelaskan kenapa urutannya tidak boleh dibalik.
Jangkar penutupOLAH itu peta jalannya, OWN itu aturan mainnya: AI membantu, kamu yang memutuskan. Sekarang kita mulai dari huruf pertama: Observasi.
Materi 2 · Leading Self 2A — Analisa Data dengan AI
02Praktik O: Observasi Data (EDA)
Durasi18 menit
Slide terkait
Alur Materi 2
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan
EDA (Exploratory Data Analysis) adalah tahap mengenali data sebelum menyimpulkan apa pun darinya: struktur kolom, tipe data, rentang nilai, data kosong, dan pola kasar. Ini tahap yang paling sering dilewati orang yang buru-buru — padahal ini yang menentukan apakah insight di tahap berikutnya bisa dipercaya atau tidak.
Ingat aturan dari framework DATA (LS1 bagian 07): AI dilarang berasumsi kalau data tidak lengkap, dan wajib bertanya balik kalau ada yang ambigu. Di tahap Observasi ini, aturan itu diterapkan paling ketat — karena kesalahan pemahaman data di sini akan menjalar ke semua tahap berikutnya.
Bonus: Kalau Skill Muncul
Kalau akun peserta punya akses ke skill Analyze Data Quality atau Create Data Context (dicek di bagian 00–01), ini bisa mempercepat langkah 2 — skill tersebut biasanya sudah menjalankan pemeriksaan serupa secara otomatis. Tetap validasi manual di langkah 3, skill tidak menggantikan itu.
Kesalahan Umum yang Perlu Diwaspadai
Langsung minta insight tanpa observasi dulu — lompat ke tahap L sebelum O selesai.
Percaya angka ringkasan AI tanpa cek manual — terutama untuk dataset yang peserta sendiri belum hafal isinya.
Mengabaikan data kosong/anomali yang ditemukan di tahap ini — catat, jangan dilewati begitu saja karena akan memengaruhi keakuratan insight nanti.
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Langkah Praktik
Upload dataset (yang sudah disiapkan & dianonimkan di bagian 00 — atau dataset_penjualan_retail_dummy.xlsx kalau pakai cadangan) ke ChatGPT.
Jalankan prompt observasi memakai template di bawah.
Baca hasilnya kritis — jangan langsung percaya. Cek 2-3 angka yang disebutkan AI dengan membuka file aslinya secara manual.
Catat temuan kunci: berapa baris/kolom, kolom mana yang banyak kosong, ada anomali atau tidak — ini jadi bekal ke tahap Lacak Insight.
Template Prompt Observasi (Framework DATA)
Berikut data [nama dataset, mis. "penjualan Q3"] (terlampir).

Lakukan observasi awal (EDA) HANYA berdasarkan data ini:
1. Sebutkan jumlah baris dan kolom, serta tipe data tiap kolom.
2. Identifikasi kolom yang punya nilai kosong/hilang, sebutkan berapa persen.
3. Sebutkan rentang nilai (min-max) untuk kolom angka.
4. Tandai anomali yang terlihat (nilai ekstrem, duplikat, format tidak
   konsisten) — jangan simpulkan penyebabnya, cukup tandai.
5. Untuk setiap poin di atas, sebutkan kolom yang jadi sumbernya.

Jangan berasumsi apa pun tentang data yang tidak terlihat di file ini.
Kalau ada bagian yang tidak jelas atau butuh saya konfirmasi, tanya dulu
sebelum melanjutkan.
Tahapan Pelaksanaan
Jelaskan konsep EDA dan kaitannya dengan framework DATA (3').
Praktik: peserta jalankan prompt observasi pada dataset masing-masing (10').
Diskusi singkat: apa temuan kunci masing-masing peserta, adakah yang AI tandai perlu konfirmasi (3').
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta mampu:
Meminta AI melakukan EDA (Exploratory Data Analysis) dasar pada dataset kerja mereka.
Menyusun prompt observasi yang mengikuti aturan framework DATA (tidak mengarang, wajib cite sumber).
Mengenali kapan data punya masalah (kosong, tidak konsisten) sebelum lanjut ke tahap insight.
Capaian Bagian Ini
Konsep: EDA adalah tahap wajib sebelum menyimpulkan apa pun dari data.
Mekanisme: Prompt observasi yang eksplisit melarang asumsi dan mewajibkan sitasi kolom menghasilkan profil data yang lebih bisa dipercaya daripada sekadar "ringkas data ini".
Indikator Keberhasilan
Setiap peserta berhasil menjalankan prompt observasi dan mencatat minimal 2 temuan kunci (termasuk potensi masalah data, kalau ada) sebelum bagian ini berakhir.
Jangkar penutupData sudah dikenali. Sekarang kita gali insight-nya — tapi tetap dengan aturan main yang sama: tidak boleh mengarang.
Materi 2 · Leading Self 2A — Analisa Data dengan AI
03Praktik L: Lacak Insight
Durasi16 menit
Slide terkait
Alur Materi 2
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan
Observasi (tahap O) menjawab "apa isi data ini?". Insight (tahap L) menjawab "jadi apa artinya, dan apa yang perlu dilakukan?". Insight yang baik selalu bisa ditelusuri balik ke observasi — kalau AI memberi insight yang tidak bisa ditunjukkan sumbernya dari data, itu tanda halusinasi, bukan analisis.
Di tahap ini, dua framework digabung: SIAP (LS1 bagian 03) untuk menyusun prompt yang terarah, dan DATA (LS1 bagian 07) untuk memastikan hasilnya tidak mengarang.
Bonus: Kalau Skill Muncul
Skill Data Analytics (kalau ada di akun peserta) bisa membantu proses ini berjalan lebih terstruktur, kadang dengan visualisasi otomatis. Aturan sitasi dan validasi manual tetap wajib — skill tidak menghilangkan kewajiban itu.
Kesalahan Umum yang Perlu Diwaspadai
Pertanyaan insight terlalu umum ("kasih insight dari data ini") — hasilnya generik dan sulit diverifikasi. Selalu spesifik seperti di tahap observasi.
Menerima insight tanpa cek sitasi — ini titik paling rawan halusinasi di seluruh alur OLAH.
Insight yang sebenarnya cuma pengulangan observasi — insight harus menjawab "jadi apa", bukan cuma mengulang angka mentah.
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Template Prompt Insight (SIAP + DATA)
Kamu analis data untuk [konteks pekerjaan, mis. tim operasional retail] (S).

Berdasarkan data yang sudah kita observasi tadi, cari insight terkait
[pertanyaan spesifik, mis. "tren penjualan bulanan" atau "produk mana yang
paling sering retur"] (I).

Aturan:
1. Insight HANYA boleh berdasarkan data yang sudah diupload — jangan
   menambahkan asumsi dari luar data.
2. Untuk setiap insight, sebutkan baris/kolom yang jadi dasarnya.
3. Kalau data tidak cukup untuk menjawab pertanyaan ini, katakan begitu —
   jangan dipaksakan. (A)

Format: maksimal 3 insight, tiap insight 1 kalimat + 1 kalimat sitasi
sumber datanya (P).
Langkah Praktik
Dari temuan observasi di bagian 02, rumuskan 1 pertanyaan insight yang konkret (bukan "kasih insight dong" — terlalu umum).
Jalankan template di atas.
Untuk tiap insight yang keluar, cek manual apakah sitasi sumbernya benar-benar cocok dengan isi file.
Kalau ada insight tanpa sitasi jelas atau sitasinya meleset — tandai sebagai "belum tervalidasi", bawa ke tahap Validasi (bagian 05).
Ulangi untuk 1-2 pertanyaan insight lain kalau waktu memungkinkan.
Tahapan Pelaksanaan
Jelaskan beda observasi vs insight, dan kenapa sitasi wajib (3').
Bagikan template prompt, contoh insight yang benar vs yang mencurigakan (3').
Praktik: peserta rumuskan pertanyaan insight dan jalankan prompt (8').
Cek cepat: minta 2-3 peserta membacakan satu insight + sitasinya, kelas menilai apakah sitasinya masuk akal (2').
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta mampu:
Membedakan observasi (deskriptif) dari insight (actionable).
Menyusun prompt insight yang menggabungkan framework SIAP dan DATA.
Menghasilkan minimal 2 insight dari dataset kerja, masing-masing dengan sitasi sumber.
Capaian Bagian Ini
Konsep: Insight yang valid selalu bisa ditelusuri balik ke baris/kolom sumbernya.
Mekanisme: Menggabungkan SIAP (arah instruksi jelas) dengan DATA (larangan mengarang + wajib sitasi) menghasilkan insight yang lebih bisa dipertanggungjawabkan dibanding prompt insight generik.
Indikator Keberhasilan
Setiap peserta menghasilkan minimal 2 insight dengan sitasi sumber, dan berhasil mengidentifikasi setidaknya satu contoh (nyata atau simulasi) di mana sitasi perlu diperiksa ulang.
Jangkar penutupInsight sudah di tangan, tapi masih mentah. Sekarang kita rapikan jadi sesuatu yang bisa dibaca orang lain.
Materi 2 · Leading Self 2A — Analisa Data dengan AI
04Praktik A: Atur jadi Presentasi/Report
Durasi18 menit
Slide terkait
Alur Materi 2
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan
Insight yang sudah divalidasi sitasinya (bagian 03) masih dalam bentuk mentah — belum tentu enak dibaca atasan atau klien. Tahap Atur (A) menyusun insight itu jadi format yang bisa dikonsumsi orang lain: ringkasan eksekutif singkat + visual pendukung, bukan tumpukan data mentah.
Prinsip format: audiens (atasan/klien) butuh kesimpulan dulu, detail belakangan. Struktur yang disarankan: headline (1 kalimat inti) → 3-5 poin insight → rekomendasi tindakan (kalau relevan).
Dari Output AI ke Hasil Kerja (OWN) *
Laporan AI sering terlihat sempurna — struktur rapi, bahasa korporat, paragraf panjang — tetapi belum ada keputusan di dalamnya. Atasan tidak butuh analisis panjang; atasan butuh tahu apa yang terjadi, kenapa penting, dan siapa melakukan apa. Sebelum laporan dikirim, pastikan lima unsur ini ada:
Unsur
Pertanyaan yang dijawab
Masalah (Issue)
Apa yang sebenarnya terjadi di lapangan?
Dampak (Impact)
Kenapa manajemen harus peduli?
Kesimpulan (Conclusion)
Apa hasil pemikiranmu — bukan sekadar daftar kemungkinan dari AI?
Tindakan (Action)
Langkah konkret apa yang harus dilakukan?
Pemilik (Owner)
Siapa yang mengeksekusi, dan kapan tenggatnya?
AI bisa membantu menstruktur kelima unsur ini. Tetapi kesimpulan, tindakan, dan pemilik adalah penilaian manusia — AI tidak tahu situasi lapangan, siapa yang punya kapasitas, atau apa yang realistis minggu ini.
Jangan teruskan output AI — teruskan kesimpulanmu
Jangan kirim
Kirim
"AI mengidentifikasi 7 kemungkinan penyebab penurunan penjualan. Silakan lihat hasil lengkapnya di bawah." (meneruskan data mentah; penerima harus berpikir sendiri)
"Saya sudah meninjau kemungkinan penyebab. Berdasarkan data kita, penyebab #2 dan #5 relevan. Kesimpulan: penurunan terkonsentrasi di satu cabang. Rekomendasi: cek ulang stok cabang itu. Tindakan: Tim operasional, Jumat."
Pola yang dihindari (forwarding problem): staf meneruskan email AI ke supervisor, supervisor meneruskan ke manajer — semua meneruskan, tidak ada yang memproses. Pertanyaan penguji: "So what? Apa kesimpulannya, apa yang harus kita lakukan?"
Bonus: Kalau Skill Muncul
Skill Visualize Data bisa mempercepat pembuatan chart. Skill Data Analytics: Publish Artifact bisa langsung menerbitkan hasil (dashboard/laporan) ke link publik (misalnya di Vercel) yang bisa dibagikan.
Peringatan Keras Sebelum Publish
Kalau memakai fitur publish ke link publik:
Jangan pernah menerbitkan dashboard/laporan berisi data klien atau data pribadi asli ke link publik. Link publik berarti siapa pun yang memegang link — bukan cuma tim internal — bisa mengaksesnya. Ini pelanggaran langsung terhadap prinsip di LS1 bagian 04: anggap semua yang masuk ke AI eksternal berpotensi tidak privat, apalagi kalau hasilnya sengaja dipublikasikan.
Kalau perlu membagikan hasil ke pihak lain, pastikan dulu: (1) data sudah dianonimkan sejak tahap 00, (2) link dibagikan lewat kanal internal yang diatur akses, bukan disebar bebas, (3) sesuai kebijakan berbagi data organisasi/klien.
Kesalahan Umum yang Perlu Diwaspadai
Headline melebih-lebihkan insight yang sebenarnya lemah — kembali cek ke sitasi sumber di tahap L.
Mencampur fakta (temuan data) dengan opini (rekomendasi) tanpa penanda jelas — audiens bisa salah mengira rekomendasi sebagai fakta.
Langsung publish tanpa mikir siapa yang bisa akses link — ini kesalahan paling berisiko di tahap ini.
Laporan tanpa pemilik dan tenggat — rapi, tetapi tidak ada yang bergerak setelah dibaca. *
Meneruskan output AI mentah dengan catatan "FYI" — penerima tidak tahu apa yang harus dilakukan. *
2
Apa yang kita lakukan
Langkah, praktik, dan template yang dipakai
Template Prompt Menyusun Report
Dari insight yang sudah kita bahas, susun ringkasan eksekutif untuk
[audiens, mis. "atasan saya" atau "tim manajemen"] (S + I dari SIAP).

Format:
1. Satu kalimat headline yang merangkum temuan utama.
2. 3-5 poin insight, masing-masing 1-2 kalimat, tetap sertakan sumber
   datanya secara singkat (P dari SIAP + audit sumber dari DATA).
3. Rekomendasi tindakan (kalau ada) — tandai jelas mana yang rekomendasi
   (opini) dan mana yang temuan data (fakta), jangan dicampur (A dari SIAP).
4. Tambahkan satu baris DAMPAK (kenapa ini penting untuk [audiens]) dan
   kolom TINDAKAN yang kosong untuk PEMILIK + TENGGAT — jangan isi sendiri,
   biarkan saya yang menentukan.

Nada: profesional, ringkas, tidak bertele-tele. Maksimal 200 kata untuk
seluruh ringkasan.
Untuk visual pendukung, minta terpisah setelah teks:
Buatkan 1-2 grafik yang mendukung insight di atas — pilih jenis grafik
yang paling sesuai dengan jenis datanya (tren waktu = line chart,
perbandingan kategori = bar chart, dst).
Langkah Praktik
Jalankan template ringkasan eksekutif menggunakan insight dari bagian 03.
Minta grafik pendukung secara terpisah.
Baca ulang: apakah headline benar-benar mencerminkan insight, atau malah melebih-lebihkan?
Susun jadi satu dokumen/slide sederhana (bisa langsung dari teks + gambar chart yang dihasilkan).
Isi sendiri kesimpulan, tindakan, pemilik, dan tenggat — empat hal yang tidak boleh diserahkan ke AI. *
Tahapan Pelaksanaan
Jelaskan struktur report (headline → poin → rekomendasi), pemisahan fakta/opini, dan lima unsur hasil kerja: Masalah, Dampak, Kesimpulan, Tindakan, Pemilik (4'). *
Bagikan template, jalankan bersama untuk satu contoh (3').
Praktik: peserta susun ringkasan eksekutif + chart dari insight masing-masing, lalu isi sendiri Tindakan, Pemilik, dan Tenggat (8'). *
Tekankan peringatan publish, cek apakah ada peserta yang berencana publish ke link publik (3').
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta mampu:
Menyusun insight mentah jadi ringkasan eksekutif yang siap dibaca audiens.
Meminta AI membuat visual (chart) pendukung untuk laporan.
Mengubah output AI menjadi hasil kerja yang punya kesimpulan, tindakan, dan pemilik (OWN). *
Menerapkan prinsip keamanan data saat mempublikasikan hasil.
Capaian Bagian Ini
Konsep: Report yang baik memisahkan fakta (temuan data) dari opini (rekomendasi), headline proporsional dengan kekuatan insight, dan hasil kerja selalu punya kesimpulan, tindakan, serta pemilik. Output AI belum menjadi hasil kerja sampai manusia melengkapinya. *
Mekanisme: Mempublikasikan hasil ke link publik mengubah risiko keamanan data dari "internal" jadi "siapa saja yang punya link" — keputusan ini butuh pertimbangan eksplisit, bukan default.
Indikator Keberhasilan
Setiap peserta punya satu ringkasan eksekutif + minimal 1 chart pendukung, bisa menjelaskan bagian mana yang fakta vs opini, dan laporannya memuat Tindakan + Pemilik + Tenggat yang diisi sendiri. *
Jangkar penutupLaporan sudah rapi dan ada pemiliknya — tapi rapi bukan berarti benar. Sebelum dikirim ke siapa pun, kita validasi dulu.
Materi 2 · Leading Self 2A — Analisa Data dengan AI
05Praktik H: Hasil Divalidasi
Durasi13 menit
Slide terkait
Alur Materi 2
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan
Ini tahap terakhir OLAH, dan tahap yang paling sering dilewati karena laporan sudah terlihat rapi di tahap A. Padahal "terlihat rapi" tidak sama dengan "benar". Ingat batas dari framework DATA (LS1 bagian 07): framework anti-halusinasi mengurangi risiko, tapi tidak menghilangkannya. Validasi manusia tetap wajib untuk keputusan yang berisiko — dan laporan yang dikonsumsi orang lain (atasan, klien) selalu masuk kategori ini.
Fakta vs Asumsi AI *
Contoh kasus: sebuah cabang hanya mencapai 73 transaksi/hari dibanding 140 di cabang lain. AI langsung menyebut empat penyebab: kurang tenaga kerja, pelatihan buruk, tata letak tidak efisien, kekurangan alat. Pertanyaan kritisnya: mana yang benar-benar kita ketahui?
Fakta (terbukti): cabang ini 73/hari, cabang lain 140/hari.
Asumsi AI (belum terbukti): "kurang orang", "pelatihan buruk", dst. — AI menebak penyebab tanpa data yang menunjukkannya.
Rekomendasi AI "tambah dua karyawan" berdiri di atas asumsi. Hasil kerja yang benar menulis Fakta, Belum diketahui, Kesimpulan (ada gap, akar penyebab belum terbukti — jangan tambah orang dulu), dan Tindakan + Pemilik + Tenggat (ukur 3 hari, Manajer Cabang, Jumat).
Uji Kepemilikan (OWN) Sebelum Kirim *
Setelah lima poin validasi di atas lolos, tambahkan lima pertanyaan ini. Satu saja dijawab "tidak" = belum siap kirim:
Apakah saya bisa menjelaskan laporan ini tanpa melihat layar AI?
Apakah kesimpulan ini milik saya — bukan sekadar salinan dari AI?
Apakah ada tindakan, pemilik, dan tenggat yang jelas?
Apakah saya sudah memisahkan fakta dari asumsi AI?
Kalau atasan bertanya "kenapa angka ini?", saya yang menjawab, bukan "kata AI"?
Jadikan AI mitra berpikir, bukan mesin penjawab. Sebelum kirim, minta AI menguji kesimpulanmu: "Apa asumsi yang saya buat? Risiko apa yang mungkin saya lewatkan? Apa yang bisa membuat rencana ini gagal? Pertanyaan kritis apa yang akan diajukan Direktur?"
Batas Otoritas: Keputusan yang Tetap di Manusia *
AI boleh menganalisis, membandingkan, dan memberi saran di semua bidang. Tetapi untuk area berikut, hanya manusia yang mengambil keputusan akhir — dan manusia itu yang menanggung akibatnya:
Area
Contoh keputusan
Keselamatan & kualitas
Standar mutu produk, keamanan kerja
Karyawan (SDM)
Penilaian kinerja, rekrutmen
Keuangan & komersial
Harga, komitmen ke klien
Spesifikasi teknis
Perubahan parameter mesin/sistem
Hukum
Kesepakatan kontrak
Aturan praktis: kalau keputusannya menyangkut salah satu area ini, AI memberi bahan, kamu menandatangani.
Bonus: Kalau Skill Muncul
Skill Validate Data (kalau ada di akun peserta) bisa membantu langkah 1-2 secara otomatis. Langkah 3-5 tetap wajib dilakukan manusia — ini soal penilaian konteks (proporsionalitas, pemisahan fakta/opini) yang tidak sepenuhnya bisa didelegasikan ke AI, termasuk AI yang memvalidasi AI lain.
Kesalahan Umum yang Perlu Diwaspadai
Melewati tahap ini karena "sudah keburu terlihat bagus" — ini justru sinyal untuk lebih hati-hati, bukan lebih santai.
Minta AI yang sama untuk "validasi ulang" tanpa membuka data asli — AI yang sama bisa mengulangi kesalahan yang sama. Validasi butuh sumber independen (file asli, bukan cuma tanya ulang ke AI).
Menganggap validasi selesai kalau checklist "lolos semua" — checklist ini meminimalkan risiko, bukan menghilangkannya sepenuhnya.
Menjadikan AI alasan lepas tangan ("kata AI begitu") — tanggung jawab akhir ada pada pengirim, bukan pada sistem. *
Menyerahkan keputusan di area otoritas ke AI — keselamatan, SDM, keuangan, spesifikasi teknis, dan hukum selalu keputusan manusia. *
Cek ulang 2-3 angka kunci di laporan — buka file data asli, cocokkan manual, jangan percaya begitu saja pada sitasi yang diberikan AI.
Cek konsistensi istilah dan satuan — apakah AI mengganti istilah asli data dengan sinonim, atau membulatkan angka tanpa menyebutkannya?
Cek proporsi headline vs data pendukung — apakah kesimpulan besar didukung data yang cukup, atau dilebih-lebihkan?
Cek pemisahan fakta vs opini — apakah rekomendasi ditandai jelas terpisah dari temuan data (dari bagian 04)?
Cek bagian yang AI tandai "tidak cukup data" — apakah bagian itu diam-diam hilang di draf akhir, atau tetap disebutkan sebagai keterbatasan?
Langkah Praktik
Ambil laporan hasil bagian 04.
Jalankan checklist di atas satu per satu — catat hasilnya (lolos/tidak untuk tiap poin).
Kalau ada yang gagal, kembali ke tahap L atau A untuk memperbaiki — jangan dilanjutkan begitu saja.
Jalankan Uji Kepemilikan (OWN) di atas — jawab lima pertanyaan, catat mana yang "tidak". *
Untuk kelas: pasangkan 2 peserta untuk saling cek laporan satu sama lain (validator eksternal biasanya menemukan hal yang si pembuat laporan lewatkan). Penguji juga bertanya satu hal: "Kesimpulan ini punya siapa?"*
Tahapan Pelaksanaan
Jelaskan kenapa tahap ini tidak boleh dilewati, lalu bagikan checklist 5 poin (3').
Paparkan fakta vs asumsi, uji kepemilikan (OWN), dan batas otoritas (4'). *
Praktik: peserta jalankan checklist 5 poin pada laporan masing-masing (3').
Praktik berpasangan: saling cek laporan + jalankan uji OWN (3'). Kalau waktu mepet, potong contoh kasus, jangan potong uji OWN.*
3
Target
Apa yang harus dicapai & cara mengukurnya
Target Pembelajar
Setelah bagian ini, peserta mampu:
Menjalankan checklist validasi manual sebelum laporan dipakai/dikirim.
Mengidentifikasi klaim mana dalam laporan yang paling berisiko kalau salah.
Menjelaskan kenapa tahap ini tidak boleh dilewati, sekuat apa pun laporan terlihat.
Memisahkan fakta dari asumsi AI, dan menjalankan uji kepemilikan (OWN) sebelum mengirim. *
Menyebutkan keputusan yang tidak boleh diserahkan ke AI (batas otoritas). *
Capaian Bagian Ini
Konsep: "Terlihat rapi" bukan indikator "benar" — validasi butuh langkah eksplisit dan sumber independen.
Kepemilikan: Pengirim laporan adalah pemiliknya. Fakta harus dipisahkan dari asumsi AI, dan keputusan di area otoritas tidak boleh didelegasikan ke AI. *
Mekanisme: Checklist manual + uji OWN + validasi silang antar-peserta menangkap kesalahan yang tidak terlihat oleh pembuat laporan sendiri.
Indikator Keberhasilan
Setiap peserta menyelesaikan checklist validasi dan uji OWN pada laporannya sendiri, dan minimal separuh peserta menemukan minimal satu hal yang perlu diperbaiki (termasuk kesimpulan yang ternyata hanya salinan dari AI). *
Jangkar penutupOLAH selesai satu putaran penuh — dan kamu pemilik hasilnya. AI membantu, manusia memutuskan. Sekarang kita rangkum semuanya.
Materi 2 · Leading Self 2A — Analisa Data dengan AI
06Penutup dan Rencana Tindak Lanjut
Durasi5 menit
Slide terkait
Alur Materi 2
1
Penjelasan
Konsep & alasan di balik bagian ini
Penjelasan
Rangkuman alur sesi (bacakan cepat, satu napas):
Kenali data dulu sebelum menyimpulkan (Observasi) → gali insight yang bisa ditelusuri sumbernya (Lacak Insight) → susun jadi laporan yang memisahkan fakta dari opini dan punya pemilik (Atur Presentasi) → jangan pernah kirim/publish sebelum dicek manual (Hasil Divalidasi) — dan ingat: AI membantu, manusia memutuskan; yang kamu kirim, kamu yang memiliki.*
Ini semua dibangun di atas fondasi Leading Self 1: SIAP untuk menyusun instruksi, GALI untuk saat belum tahu harus mulai dari mana, DATA untuk mencegah AI mengarang, dan prinsip keamanan data untuk menjaga apa yang boleh dan tidak boleh masuk ke AI eksternal.
Perbandingan Singkat: Leading Self 1 vs Leading Self 2A
Leading Self 1
Leading Self 2A
Fokus
Kerja AI untuk individu
Kerja AI untuk hasil yang dikonsumsi orang lain
Output
Jawaban/draf personal
Laporan/presentasi yang bisa dipertanggungjawabkan
Framework
SIAP, GALI, DATA
OLAH (memakai ketiganya secara bertahap)
Risiko utama
Prompt tidak jelas, data bocor
Insight tidak tervalidasi dikonsumsi orang lain
Prinsip kunci
Aman dulu, baru produktif
OWN: AI membantu, manusia memutuskan, pengirim bertanggung jawab
Rencana Pengembangan Lanjutan
Leading Self 2B (usulan): kustomisasi skill/GPT khusus untuk jenis data yang berulang dikerjakan tim (mis. laporan penjualan bulanan, monitoring kualitas produksi).
Leading Self 3 (usulan): dari analisis individual ke kolaborasi tim — bagaimana beberapa orang memakai dataset dan alur OLAH yang sama secara konsisten.